Célula de Ensino evolução que gera resultados
Engenharia Operacional de LLMs: Previsão, Alinhamento e Integração de Sistemas

Alinhamento, Fine-Tuning e Viés de Dados em LLMs: Da Leitura Crua da Web ao RLHF e a Mitigação do Viés em Triagem de Currículos

Um modelo treinado apenas com a leitura crua da internet gera respostas frequentemente desconexas ou tóxicas. Ele precisa ser domado para se tornar útil. Nesta trilha avançada da Frente Operacional 2, você dominará as três etapas do ciclo moderno de alinhamento: Ajuste Fino Supervisionado (SFT), Aprendizado por Reforço com Feedback Humano (RLHF) e Otimização Direta de Preferência (DPO). Investigará em detalhes por que a IA atua como um espelho de seus dados de origem e herda as falhas estruturais da sociedade que a programou — dissecando o caso clássico do algoritmo de triagem de currículos que penalizou mulheres ao automatizar uma década de contratações majoritariamente masculinas — e aprenderá a desenhar pipelines de mitigação e auditoria ética.

12 células 50h Avançado
🚀 Escada de Valor • Pacotes & Credit Upgrade (R$ 29,99 a R$ 199,99)

Jornada Executiva: Sustentabilidade Estratégica & Gestão Global de Projetos (ESG)

Do curso base em Pensamento Estratégico de Sustentabilidade (R$ 29,99) à Liderança Internacional em Projetos de Clima e Captação Global (R$ 199,99).

🎯 1. Porta de Entrada (R$ 29,99) Inicie pela Trilha Start (R$ 29,99) com baixo atrito financeiro e domine os fundamentos globais na prática.
💳 2. Abatimento no Upgrade (Credit Upgrade) 100% dos R$ 29,99 investidos na Trilha Start viram crédito imediato (cupom UPGRADE29) para abater nas Trilhas 2, 3, 4 ou 5!
🌍 3. Certificação Dupla (PT-BR & EN) + ODS Certificados emitidos em Português e Inglês com competências alinhadas aos ODS da ONU para seu perfil global no LinkedIn.
Alinhamento ONU / Agenda Pós-2030: ODS 7 (Energia Limpa) ODS 9 (Indústria e Infraestrutura) ODS 12 (Consumo e Produção) ODS 13 (Ação Climática) ODS 17 (Parcerias Globais)
Sugestões CdE

Compare com trilhas semelhantes

Sugestões ligadas ao conteúdo desta trilha para apoiar sua decisão de matrícula.

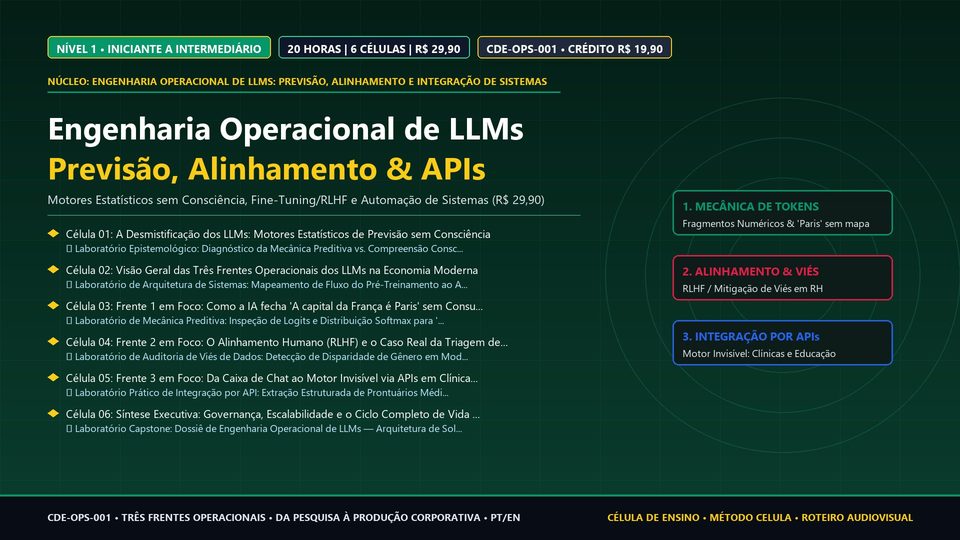
Engenharia Operacional de LLMs: Motores Estatísticos de Previsão de Texto, Alinhamento de Dados e Integração via APIs R$ 29,90
Engenharia Operacional de LLMs: Previsão, Alinhamento e Integração de Sistemas

Engenharia Operacional de LLMs: Motores Estatísticos de Previsão de Texto, Alinhamento de Dados e Integração via APIs

Compreenda por que os LLMs não possuem consciência, mas são motores estatísticos de previsão de texto alimentados por volumes massivos de dados, e domine suas três frentes operacionais: mecânica de tokens, alinhamento RLHF e integração via APIs.

📚 12 células ⏱️ 20h Iniciante a Intermediário
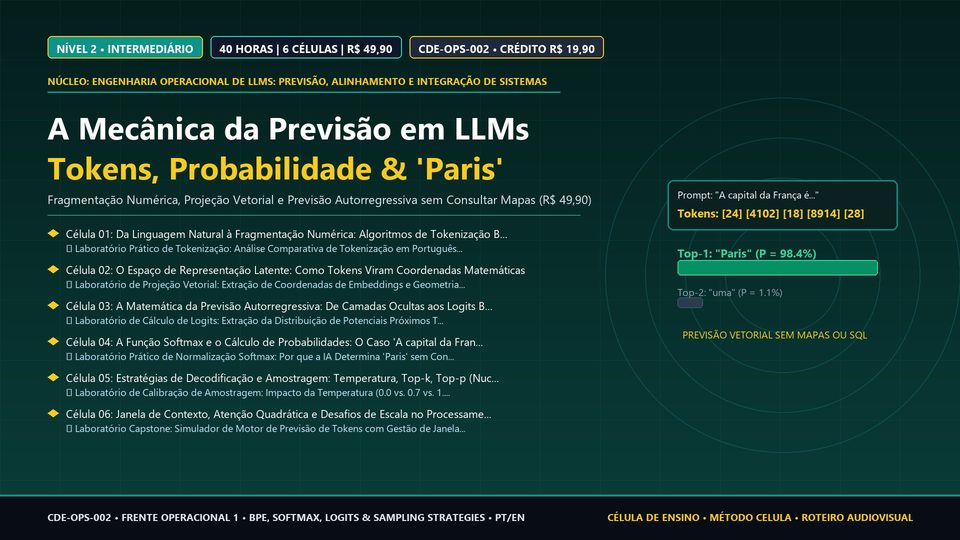
A Mecânica da Previsão em LLMs: Tokenização Subvocabular, Matrizes Probabilísticas e o Fechamento Vetorial de 'Paris' R$ 49,90
Engenharia Operacional de LLMs: Previsão, Alinhamento e Integração de Sistemas

A Mecânica da Previsão em LLMs: Tokenização Subvocabular, Matrizes Probabilísticas e o Fechamento Vetorial de 'Paris'

Domine a Frente Operacional 1 dos LLMs: como o computador fragmenta a linguagem em tokens numéricos, calcula probabilidades matemáticas do próximo token e determina que 'Paris' fecha 'A capital da França é' sem consultar mapas.

📚 12 células ⏱️ 40h Intermediário
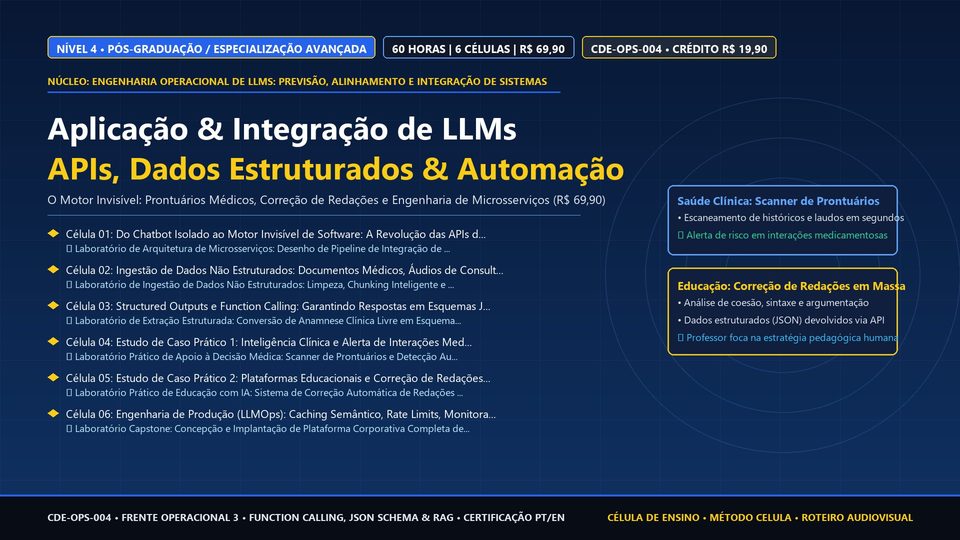
Aplicação e Integração de Sistemas de LLMs: Engenharia de APIs, Extração Estruturada de Dados e Automação Operacional em Saúde e Educação R$ 69,90
Engenharia Operacional de LLMs: Previsão, Alinhamento e Integração de Sistemas

Aplicação e Integração de Sistemas de LLMs: Engenharia de APIs, Extração Estruturada de Dados e Automação Operacional em Saúde e Educação

Domine a Frente Operacional 3 dos LLMs: como a IA atua como motor invisível por trás de softwares via APIs, processando dados não estruturados (áudios, PDFs, prontuários) e automatizando rotinas clínicas e educacionais.

📚 12 células ⏱️ 60h Pós-Graduação / Especialização Avançada
Jornada da trilha

Células de aprendizagem

1

Célula 01: O Modelo Base Cru (Base Model): Por que a Internet sem Filtro Produz Respostas Perigosas

Analisar as características de um modelo pré-treinado apenas para prever o próximo token sobre terabytes da web: propensão a completar insultos, alucinar fatos sem compromisso com a verdade e gerar instruções danosas.

5 min 🎙️ Áudio
2

Célula 01: O Modelo Base Cru (Base Model): Por que a Internet sem Filtro Produz Respostas Perigosas

Analisar as características de um modelo pré-treinado apenas para prever o próximo token sobre terabytes da web: propensão a completar insultos, alucinar fatos sem compromisso com a verdade e gerar instruções danosas.

5 min 🎙️ Áudio
3

Célula 02: Ajuste Fino Supervisionado (Supervised Fine-Tuning - SFT) para Instrução e Conversação

Estruturar pipelines de SFT com datasets de pares instrução-resposta curados de alta qualidade, ensinando o modelo a agir como assistente útil, conciso e cooperativo.

5 min 🎙️ Áudio
4

Célula 02: Ajuste Fino Supervisionado (Supervised Fine-Tuning - SFT) para Instrução e Conversação

Estruturar pipelines de SFT com datasets de pares instrução-resposta curados de alta qualidade, ensinando o modelo a agir como assistente útil, conciso e cooperativo.

5 min 🎙️ Áudio
5

Célula 03: Aprendizado por Reforço com Feedback Humano (RLHF) e Modelagem de Recompensa (Reward Modeling)

Compreender o pipeline clássico de RLHF: coleta de preferências humanas pareadas, treinamento de um Modelo de Recompensa (Reward Model) e otimização da política do LLM via Proximal Policy Optimization (PPO).

5 min 🎙️ Áudio
6

Célula 03: Aprendizado por Reforço com Feedback Humano (RLHF) e Modelagem de Recompensa (Reward Modeling)

Compreender o pipeline clássico de RLHF: coleta de preferências humanas pareadas, treinamento de um Modelo de Recompensa (Reward Model) e otimização da política do LLM via Proximal Policy Optimization (PPO).

5 min 🎙️ Áudio
7

Célula 04: Alternativas Modernas ao RLHF: Direct Preference Optimization (DPO) e RLAIF

Dominar abordagens de ponta que simplificam o alinhamento eliminando a instabilidade do PPO: Otimização Direta de Preferência (DPO) e Aprendizado por Reforço com Feedback de IA (RLAIF / Constitutional AI).

5 min 🎙️ Áudio
8

Célula 04: Alternativas Modernas ao RLHF: Direct Preference Optimization (DPO) e RLAIF

Dominar abordagens de ponta que simplificam o alinhamento eliminando a instabilidade do PPO: Otimização Direta de Preferência (DPO) e Aprendizado por Reforço com Feedback de IA (RLAIF / Constitutional AI).

5 min 🎙️ Áudio
9

Célula 05: Estudo de Caso Real: O Algoritmo de Triagem de Currículos e o Viés de Gênero Automatizado

Dissecar detalhadamente o caso histórico da gigante de tecnologia cuja IA de triagem penalizou candidatas mulheres ao analisar uma década de histórico corporativo majoritariamente masculino.

5 min 🎙️ Áudio
10

Célula 05: Estudo de Caso Real: O Algoritmo de Triagem de Currículos e o Viés de Gênero Automatizado

Dissecar detalhadamente o caso histórico da gigante de tecnologia cuja IA de triagem penalizou candidatas mulheres ao analisar uma década de histórico corporativo majoritariamente masculino.

5 min 🎙️ Áudio
11

Célula 06: Governança Ética, Red Teaming e Métricas de Auditoria Sociotécnica em Produção

Desenvolver protocolos sistemáticos de testes adversariais (Red Teaming), detecção de jailbreaks e relatórios de conformidade regulatória (EU AI Act e diretrizes brasileiras de IA).

5 min 🎙️ Áudio
12

Célula 06: Governança Ética, Red Teaming e Métricas de Auditoria Sociotécnica em Produção

Desenvolver protocolos sistemáticos de testes adversariais (Red Teaming), detecção de jailbreaks e relatórios de conformidade regulatória (EU AI Act e diretrizes brasileiras de IA).

5 min 🎙️ Áudio