Célula de Ensino evolução que gera resultados
Big Data, Armazenamento Distribuído e Engenharia de Dados

Gestão de Big Data: Armazenamento Distribuído, Ecossistema Hadoop, NoSQL e Processamento em Larga Escala com Hive

Formação profissional avançada e especialização técnica em infraestrutura de dados corporativos, armazenamento distribuído e processamento em larga escala através de frameworks abertos. O curso capacita engenheiros, arquitetos e gestores de tecnologia para liderar a gestão de volumes massivos de informação na era dos Zettabytes (cenário projetado pela IDC em mais de 175 ZB globais), explorando os fundamentos de sistemas distribuídos, os limites do scale-up versus a resiliência do scale-out em hardware commodity, e as garantias do Teorema CAP e modelo BASE. Aprofunda-se nas quatro famílias de bancos de dados NoSQL (chave-valor, wide-column, orientados a documentos e grafos) com estratégias de sharding e hashing consistente; disseca os componentes centrais do ecossistema Apache Hadoop, incluindo a arquitetura mestre-escravo do HDFS com NameNode High Availability (QJM) e DataNodes, o paradigma de computação distribuída MapReduce e o gerenciamento elástico de recursos com YARN; domina a abstração de data warehousing corporativo com Apache Hive, HiveQL, Metastore, formatos colunares otimizados (Apache Parquet e ORC com compressão Snappy/ZSTD) e técnicas de particionamento e bucketização; e consolida a governança corporativa através de pipelines de ingestão unificada (arquiteturas Lambda e Kappa, Apache Kafka/Sqoop), segurança integrada com Kerberos, controle de acesso granular com Apache Ranger e rastreabilidade de linhagem de dados com Apache Atlas.

6 células 60h Especialização Avançada e Pós-Graduação em Engenharia de Inf
🚀 Escada de Valor • Pacotes & Credit Upgrade (R$ 29,99 a R$ 199,99)

Jornada Executiva: Sustentabilidade Estratégica & Gestão Global de Projetos (ESG)

Do curso base em Pensamento Estratégico de Sustentabilidade (R$ 29,99) à Liderança Internacional em Projetos de Clima e Captação Global (R$ 199,99).

🎯 1. Porta de Entrada (R$ 29,99) Inicie pela Trilha Start (R$ 29,99) com baixo atrito financeiro e domine os fundamentos globais na prática.
💳 2. Abatimento no Upgrade (Credit Upgrade) 100% dos R$ 29,99 investidos na Trilha Start viram crédito imediato (cupom UPGRADE29) para abater nas Trilhas 2, 3, 4 ou 5!
🌍 3. Certificação Dupla (PT-BR & EN) + ODS Certificados emitidos em Português e Inglês com competências alinhadas aos ODS da ONU para seu perfil global no LinkedIn.
Alinhamento ONU / Agenda Pós-2030: ODS 7 (Energia Limpa) ODS 9 (Indústria e Infraestrutura) ODS 12 (Consumo e Produção) ODS 13 (Ação Climática) ODS 17 (Parcerias Globais)
Sugestões CdE

Compare com trilhas semelhantes

Sugestões ligadas ao conteúdo desta trilha para apoiar sua decisão de matrícula.

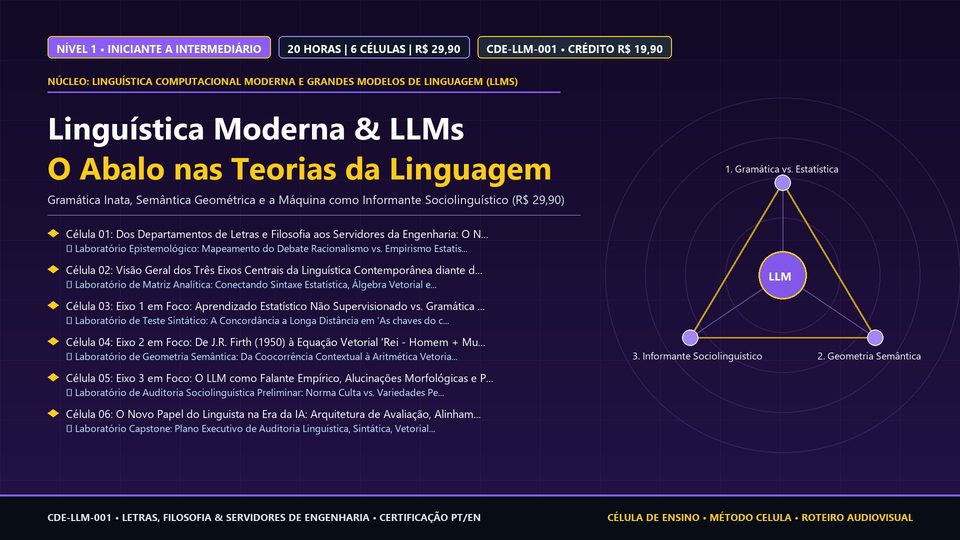
Linguística Moderna e Grandes Modelos de Linguagem (LLMs): O Abalo nas Teorias da Aquisição, Estrutura e Compreensão da Língua R$ 29,90
Linguística Computacional Moderna e Grandes Modelos de Linguagem (LLMs)

Linguística Moderna e Grandes Modelos de Linguagem (LLMs): O Abalo nas Teorias da Aquisição, Estrutura e Compreensão da Língua

Compreenda por que os Grandes Modelos de Linguagem (LLMs) não são apenas ferramentas tecnológicas, mas um abalo direto nas teorias tradicionais sobre aquisição, estrutura e compreensão da língua em três eixos.

📚 12 células ⏱️ 20h Iniciante a Intermediário
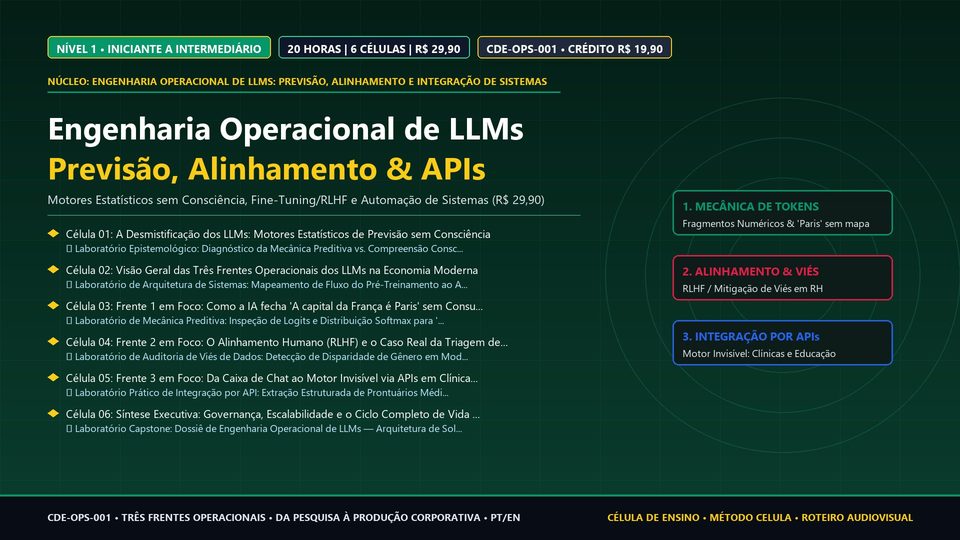
Engenharia Operacional de LLMs: Motores Estatísticos de Previsão de Texto, Alinhamento de Dados e Integração via APIs R$ 29,90
Engenharia Operacional de LLMs: Previsão, Alinhamento e Integração de Sistemas

Engenharia Operacional de LLMs: Motores Estatísticos de Previsão de Texto, Alinhamento de Dados e Integração via APIs

Compreenda por que os LLMs não possuem consciência, mas são motores estatísticos de previsão de texto alimentados por volumes massivos de dados, e domine suas três frentes operacionais: mecânica de tokens, alinhamento RLHF e integração via APIs.

📚 12 células ⏱️ 20h Iniciante a Intermediário
Jornada da trilha

Células de aprendizagem

1

A Era dos Zettabytes e Fundamentos Arquiteturais de Big Data

Compreensão aprofundada da explosão de dados corporativos e globais rumo à escala de Zettabytes (estudo IDC Global DataSphere projetando mais de 175 ZB). Análise comparativa entre escalabilidade vertical (scale-up) e escalabilidade horizontal (scale-out) baseada em clusters de nós commodity. Estudo rigoroso das leis fundamentais de sistemas distribuídos: o Teorema CAP de Eric Brewer, o teorema estendido PACELC e a transição das propriedades transacionais estritas ACID para a consistência eventual e disponibilidade contínua do modelo BASE.

10h
2

Bancos de Dados NoSQL e Modelos Não Relacionais

Estudo comparativo e arquitetural das quatro principais categorias de bancos de dados NoSQL (Not Only SQL) para dados não estruturados e semiestruturados em larga escala. Dissecação dos bancos Chave-Valor (Redis, DynamoDB), Família de Colunas Largas / Wide-Column (Apache Cassandra, HBase), Orientados a Documentos (MongoDB, Couchbase) e Orientados a Grafos (Neo4j). Técnicas avançadas de modelagem desnormalizada, particionamento horizontal por sharding, replicação com múltiplos fatores e distribuição de nós via anéis de hash consistente com nós virtuais.

10h
3

O Núcleo do Hadoop: Sistema de Arquivos Distribuído HDFS

Estudo minucioso da arquitetura mestre-escravo do Hadoop Distributed File System (HDFS), o padrão de fato para armazenamento distribuído em larga escala em clusters abertos. Anatomia detalhada do NameNode, armazenamento de metadados em memória RAM, arquivos FsImage e EditLogs, e alta disponibilidade ativa-passiva via Quorum Journal Manager (QJM) e Apache ZooKeeper. Mecanismos operacionais dos DataNodes, bloco padrão de 128 MB, fator de replicação triplo com políticas de rack awareness, comandos de linha de instrução HDFS, balanceamento de dados e tratamento do problema de arquivos pequenos (Small Files Problem).

10h
4

Processamento Distribuído: Hadoop MapReduce e YARN

Estudo aprofundado do modelo computacional distribuído Hadoop MapReduce e do sistema de orquestração e gerenciamento de recursos corporativos Apache YARN (Yet Another Resource Negotiator). Dissecação do paradigma MapReduce (Google Research 2004): funções Map, particionamento intermediário, Shuffle & Sort e funções Reduce com localidade de dados (Data Locality). Arquitetura do YARN: ResourceManager, NodeManager, ApplicationMaster e Containers elásticos. Configuração e ajuste de políticas de agendamento de recursos (Capacity Scheduler vs. Fair Scheduler) para clusters multi-inquilinos (multi-tenant).

10h
5

Data Warehousing em Big Data com Apache Hive

Estudo aprofundado do Apache Hive como a camada analítica de Data Warehousing sobre o ecossistema Hadoop. Tradução declarativa de consultas relacionais SQL em planos de execução distribuídos via HiveQL (HQL). Arquitetura do Hive: HiveServer2, Beeline CLI, Hive Driver e Metastore (banco de metadados relacional). Diferenciação estrita entre Tabelas Gerenciadas (Managed/Internal) e Tabelas Externas (External Tables). Otimização de armazenamento com formatos colunares de alta performance (Apache Parquet e Apache ORC com compressão Snappy), vetorização de consultas e estratégias de particionamento estático/dinâmico e bucketização.

10h
6

Arquiteturas Integradas, Governança e Pipelines de Big Data

Estudo e desenho de arquiteturas corporativas modernas de dados unificadas para processamento em lote e em tempo real. Dissecação da Arquitetura Lambda (Batch Layer com Hadoop, Speed Layer com Kafka/Streaming e Serving Layer com NoSQL) versus Arquitetura Kappa e o paradigma moderno de Lakehouse e Data Mesh. Integração de esteiras de ingestão distribuída de dados relacionais e streaming (Apache Sqoop, Flume e Apache Kafka). Mecanismos de governança corporativa, segurança e compliance em Big Data: autenticação criptográfica com Kerberos, controle de acesso baseado em papéis (RBAC) e mascaramento dinâmico de dados com Apache Ranger, e catálogo de metadados, classificação e rastreabilidade de linhagem (Data Lineage) com Apache Atlas.

10h