Célula de Ensino evolução que gera resultados
Sistemas Operacionais, Arquitetura do Kernel Linux e Engenharia de Sistemas

Linux como Sistema Operacional: Arquitetura do Kernel, Chamadas de Sistema, Processos, Memória e Administração de Servidores

Formação universitária aprofundada e prática em Engenharia de Sistemas Operacionais focada no Linux. Analisa a arquitetura interna do kernel monolítico modular, anéis de privilégio da CPU (Ring 0 / Kernel Mode versus Ring 3 / User Mode), sequência de inicialização (BIOS/UEFI, GRUB, vmlinuz, initramfs até o PID 1 systemd) e a interface fundamental de chamadas de sistema (Syscalls) com rastreamento via strace e manipulação de módulos LKM. Explora o ciclo de vida dos processos (task_struct), clonagem com fork/execve/clone, threads NPTL, Copy-on-Write (CoW) e o escalonador Completely Fair Scheduler (CFS) baseado em árvores rubro-negras e vruntime. Detalha a gestão de memória virtual: tabelas de páginas multinível, paginação sob demanda, TLB, page faults, alocação com Buddy System e Slab Allocator, mapeamento de memória com mmap, swap, page cache e a atuação do OOM Killer. Investiga a camada do Sistema Virtual de Arquivos (VFS - superbloco, inode, dentry, file), sistemas de arquivos com journaling (ext4) e copy-on-write (Btrfs/XFS), pseudo-sistemas /proc e /sys e multiplexação de E/S de alto desempenho com epoll e io_uring. Domina a infraestrutura de controle moderno: orquestração de serviços com systemd, controle estrito de recursos com Cgroups v2 e isolamento granular com Linux Namespaces (a base de contêineres Docker/Kubernetes). Culmina na pilha de rede do kernel (sk_buff, sockets POSIX, NAPI), filtragem de pacotes com Netfilter/nftables e eBPF, e a arquitetura de segurança do kernel com Linux Capabilities, Seccomp e controle de acesso mandatório (MAC) com SELinux e AppArmor.

6 células 60h Graduação e Pós-Graduação em Ciência da Computação, Engenhar

🚀 Escada de Valor • Pacotes & Credit Upgrade (R$ 29,99 a R$ 199,99)

Jornada Executiva: Sustentabilidade Estratégica & Gestão Global de Projetos (ESG)

Do curso base em Pensamento Estratégico de Sustentabilidade (R$ 29,99) à Liderança Internacional em Projetos de Clima e Captação Global (R$ 199,99).

🎯 1. Porta de Entrada (R$ 29,99) Inicie pela Trilha Start (R$ 29,99) com baixo atrito financeiro e domine os fundamentos globais na prática.
💳 2. Abatimento no Upgrade (Credit Upgrade) 100% dos R$ 29,99 investidos na Trilha Start viram crédito imediato (cupom UPGRADE29) para abater nas Trilhas 2, 3, 4 ou 5!
🌍 3. Certificação Dupla (PT-BR & EN) + ODS Certificados emitidos em Português e Inglês com competências alinhadas aos ODS da ONU para seu perfil global no LinkedIn.
Alinhamento ONU / Agenda Pós-2030: ODS 7 (Energia Limpa) ODS 9 (Indústria e Infraestrutura) ODS 12 (Consumo e Produção) ODS 13 (Ação Climática) ODS 17 (Parcerias Globais)
Sugestões CdE

Compare com trilhas semelhantes

Sugestões ligadas ao conteúdo desta trilha para apoiar sua decisão de matrícula.

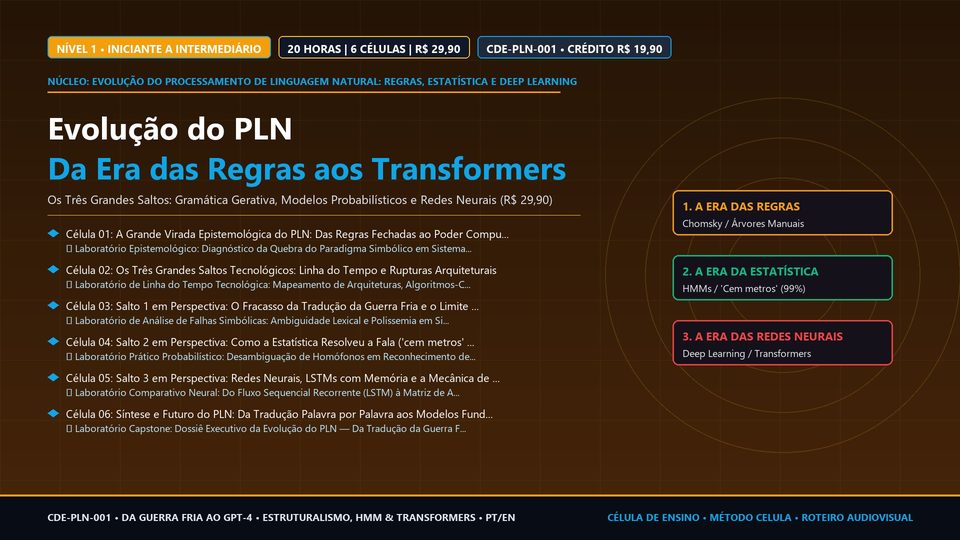
Evolução do Processamento de Linguagem Natural: Da Era das Regras Simbólicas à Estatística Massiva e à Atenção dos Transformers R$ 29,90
Evolução do Processamento de Linguagem Natural: Regras, Estatística e Deep Learning

Evolução do Processamento de Linguagem Natural: Da Era das Regras Simbólicas à Estatística Massiva e à Atenção dos Transformers

Compreenda como a ciência da computação abandonou a tentativa de ensinar regras gramaticais manuais às máquinas e passou a treiná-las com estatística massiva e redes neurais profundas através dos três grandes saltos do PLN.

📚 12 células ⏱️ 20h Iniciante a Intermediário
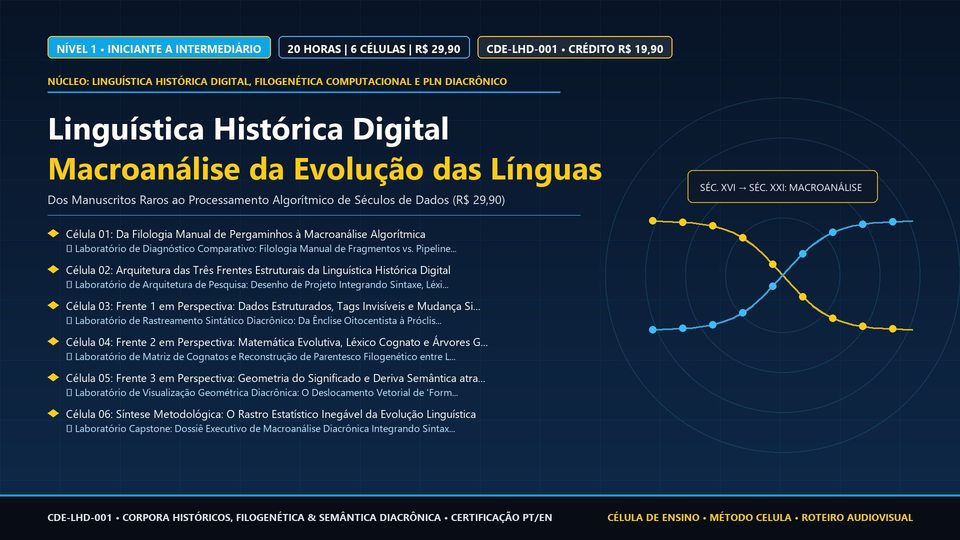
Linguística Histórica Digital: Da Filologia de Manuscritos à Macroanálise Computacional da Evolução das Línguas R$ 29,90
Linguística Histórica Digital, Filogenética Computacional e PLN Diacrônico

Linguística Histórica Digital: Da Filologia de Manuscritos à Macroanálise Computacional da Evolução das Línguas

Compreenda como a transição da linguística histórica para o ambiente digital substituiu décadas de busca manual em pergaminhos pela macroanálise computacional em três frentes: corpora morfossintáticos, filogenética bayesiana e vetores semânticos diacrônicos.

📚 12 células ⏱️ 20h Iniciante a Intermediário
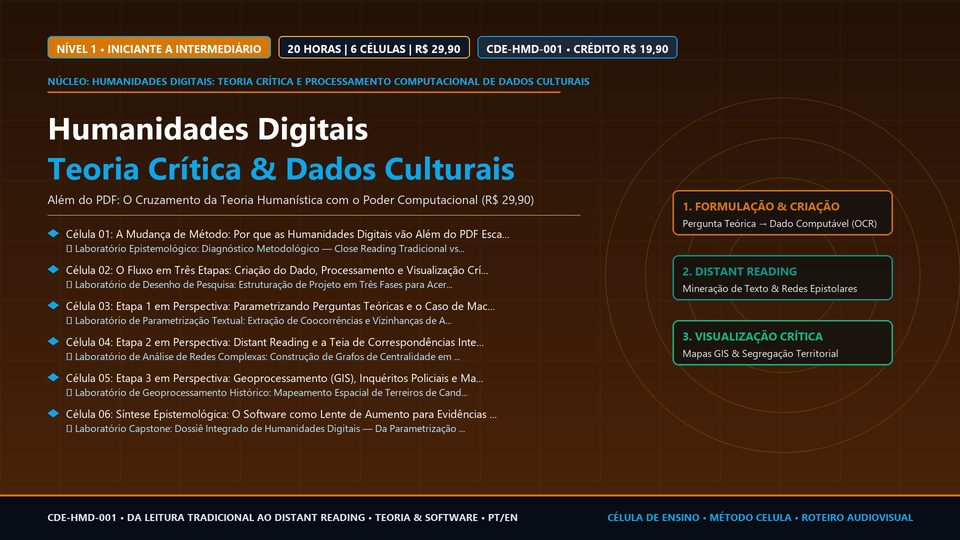
Humanidades Digitais: Teoria Crítica, Processamento de Grandes Volumes de Dados Culturais e Leitura Distante R$ 29,90
Humanidades Digitais: Teoria Crítica e Processamento Computacional de Dados Culturais

Humanidades Digitais: Teoria Crítica, Processamento de Grandes Volumes de Dados Culturais e Leitura Distante

Compreenda por que as Humanidades Digitais não são apenas escanear livros em PDF, mas uma mudança de método que cruza teoria crítica e computação em três etapas: formulação da pergunta e criação do dado, processamento macroscópico e visualização crítica.

📚 12 células ⏱️ 20h Iniciante a Intermediário
Jornada da trilha

Células de aprendizagem

1

Célula 01: Arquitetura do Kernel Linux, Inicialização do Sistema e Chamadas de Sistema (Syscalls)

Fundamentação abrangente sobre a organização interna e os mecanismos de inicialização do sistema operacional Linux. Analisa o paradigma do Kernel Monolítico Modular: todo o núcleo do sistema (gerenciamento de processos, memória, drivers de dispositivos e pilhas de protocolos) executa em um único espaço de endereçamento com privilégios máximos de hardware (Ring 0 / Kernel Mode), enquanto os processos de usuários e bibliotecas executam no espaço isolado e restrito (Ring 3 / User Mode). Examina a anatomia dos Módulos Carregáveis do Kernel (Loadable Kernel Modules - LKM): compilação de código de kernel (.ko), inserção dinâmica em tempo de execução com 'insmod' e 'modprobe', remoção segura ('rmmod'), inspeção de símbolos ('lsmod') e gerenciamento de dependências via 'modules.dep'. Disseca o fluxo cronológico da sequência de inicialização: 1) Firmware da placa-mãe (BIOS / UEFI) e execução do POST; 2) Carregador de inicialização (Bootloader GRUB 2) em múltiplos estágios; 3) Carregamento e descompressão da imagem binária do kernel executável ('vmlinuz'); 4) Montagem do sistema de arquivos temporário em memória RAM ('initramfs' ou 'initrd') contendo drivers essenciais para acessar o disco raiz; 5) Montagem do sistema de arquivos raiz definitivo ('/') em modo somente-leitura; 6) Execução do primeiro processo de espaço de usuário: o PID 1 (systemd / init). Detalha a interface de Chamadas de Sistema (Syscalls): a fronteira controlada entre Ring 3 e Ring 0 acionada por instruções de máquina especializadas ('syscall' em x86_64 e 'sysenter' em x86_32), a consulta à tabela de vetores de interrupção (sys_call_table), a troca de contexto de registradores e a recuperação de código de retorno ou errno. Apresenta ferramentas essenciais de diagnóstico como 'strace', 'dmesg' e parâmetros de linha de comando do kernel repassados pelo bootloader.

10h
2

Célula 02: Gerenciamento de Processos, Threads e o Escalonador CFS (Completely Fair Scheduler)

Investigação aprofundada dos mecanismos do kernel Linux para criação, gerenciamento de ciclo de vida e escalonamento de unidades de execução. Disseca a estrutura fundamental 'task_struct' definida em <linux/sched.h>: o descritor de processo que armazena estado do processo, identificadores de processo e usuário (PID, TGID, UID, GID), ponteiros de árvore genealógica (pai, filhos, irmãos), descritores de arquivos abertos (files_struct), informações de memória virtual (mm_struct) e contexto de sinais pendentes. Analisa a máquina de estados do processo no Linux: TASK_RUNNING (executando ou na fila de prontos), TASK_INTERRUPTIBLE (bloqueado aguardando evento ou sinal), TASK_UNINTERRUPTIBLE (bloqueado aguardando hardware/E/S de disco sem interrupção por sinais), TASK_STOPPED e o estado transitório EXIT_ZOMBIE (processo finalizado aguardando o processo pai recolher seu código de terminação via waitpid). Examina a criação de processos através da tríade clássica do Unix: 'fork()' (criação de processo filho idêntico utilizando a técnica eficiente de Copy-on-Write / CoW), 'execve()' (substituição integral da imagem de memória pelo novo binário executável ELF) e 'waitpid()' (sincronização de término e liberação de recursos da task_struct). Apresenta a chamada de sistema flexível 'clone()' e o modelo de Threads NPTL (Native POSIX Thread Library): no Linux, threads são tratadas pelo kernel como 'processos leves' (tasks) que compartilham o mesmo espaço de endereçamento de memória (CLONE_VM) e descritores de arquivo (CLONE_FILES). Aprofunda-se na arquitetura do Escalonador de Processos CFS (Completely Fair Scheduler): modelo baseado em árvores rubro-negras balanceadas (red-black trees) onde a chave de ordenação é o tempo virtual de execução ('vruntime'). Explora as classes de escalonamento (SCHED_NORMAL/OTHER, SCHED_BATCH, SCHED_FIFO e SCHED_RR para tempo real brando) e a calibração de prioridades com valores 'nice' (-20 a +19).

10h
3

Célula 03: Gerenciamento de Memória Virtual, Paginação e o OOM Killer

Análise técnica exaustiva do subsistema de memória do Linux, responsável por abstrair a memória física e fornecer a cada processo um espaço de endereçamento linear, protegido e virtualmente ilimitado. Inicia com a estrutura do Espaço de Endereçamento do Processo em sistemas de 64 bits (x86_64): segmento de texto (código executável somente-leitura), segmento de dados inicializados (.data) e não inicializados (.bss), Heap (crescimento para endereços mais altos controlado por 'brk' e 'sbrk'), área de mapeamento de memória (bibliotecas compartilhadas dinâmicas e arquivos mapeados) e Pilha (Stack: crescimento descendente para variáveis locais e frames de chamada). Explora a cooperação entre hardware (MMU) e kernel: tabelas de páginas multinível de 4 ou 5 níveis (PGD, P4D, PUD, PMD, PTE), tamanho padrão de página de 4 KiB e Huge Pages (2 MiB e 1 GiB para redução de overhead), o cache Translation Lookaside Buffer (TLB) e o tratamento de Page Faults: faltas de página menores (Minor Page Faults: resolução sem E/S de disco, como na alocação sob demanda) versus faltas maiores (Major Page Faults: leitura obrigatória de bloco em armazenamento secundário ou swap). Analisa a chamada de sistema 'mmap()': alocação de páginas anônimas ('MAP_ANONYMOUS') e arquivos mapeados em memória ('MAP_SHARED' versus 'MAP_PRIVATE' com Copy-on-Write). Dissecar os alocadores internos do kernel: o 'Buddy System Allocator' (algoritmo dos parceiros binários para alocação de blocos de páginas contíguas) e o 'Slab Allocator' (com variantes Slub e Slob: alocação e reaproveitamento rápido de objetos pequenos do kernel para evitar fragmentação interna). Finaliza com o subsistema de memória secundária: Page Cache (cache unificado de páginas para leitura e escrita assíncrona com 'dirty pages'), swapiness, recuperação de memória e o mecanismo extremo do OOM Killer (Out-Of-Memory Killer), que calcula scores de heurística ('oom_score' e ajuste 'oom_score_adj') para terminar processos e salvar o kernel em situações de esgotamento total de memória física.

10h
4

Célula 04: O Sistema Virtual de Arquivos (VFS), Armazenamento e E/S de Alto Desempenho

Mergulho profundo na arquitetura de armazenamento do Linux e na famosa máxima herdada da filosofia Unix: 'no Linux, quase tudo é um arquivo'. Inicia com a camada de abstração do VFS (Virtual File System): a interface polimórfica que unifica sistemas de arquivos heterogêneos locais e de rede sob uma árvore de diretórios unificada (/), provendo operações padronizadas (open, read, write, close, lseek). Disseca os quatro objetos fundamentais do VFS: 1) Superbloco ('super_block'): metadados globais sobre o sistema de arquivos montado (tamanho de bloco, contadores de inodes e blocos livres); 2) Nó de Índice ('inode'): representa um arquivo ou diretório físico concreto, contendo permissões POSIX, proprietário (UID/GID), timestamps (atime, mtime, ctime), tamanho em bytes e ponteiros de blocos de dados em disco — mas sem armazenar o nome do arquivo; 3) Entrada de Diretório ('dentry'): elemento de cache de nomes de arquivos em memória (Dentry Cache / dcache) que mapeia nomes de caminhos aos respectivos números de inode, acelerando a resolução de caminhos; 4) Objeto de Arquivo Aberto ('file'): representa a instância de um arquivo aberto por um processo, armazenando o descritor de arquivo (fd), a posição corrente do cursor (offset) e flags de abertura. Compara as tecnologias de sistemas de arquivos nativos: ext4 (uso de árvores de extensão / extents, journaling com três modos: journal, ordered e writeback), XFS (escalabilidade para arquivos gigantescos com alocação baseada em B+ trees) e Btrfs (Copy-on-Write nativo, subvolumes, snapshots instantâneos e suporte a RAID integrado). Examina os pseudo-sistemas de arquivos em memória: '/proc' (visão dinâmica do estado do kernel e hardware) e '/sys' (árvore estruturada de dispositivos, barramentos e drivers via sysfs). Conclui com a evolução dos modelos de multiplexação de E/S no Linux: limitações históricas de escalabilidade de 'select()' e 'poll()' (complexidade O(n) por chamada) superadas pela arquitetura baseada em eventos 'epoll()' (complexidade O(1)) e a revolução da interface assíncrona de alto desempenho 'io_uring' com anéis de submissão e conclusão em memória compartilhada sem trocas de contexto.

10h
5

Célula 05: Inicialização com Systemd, Isolamento com Namespaces e Cgroups v2

Exploração dos subsistemas modernos de gerenciamento e isolamento do Linux que sustentam toda a revolução dos contêineres e a infraestrutura em nuvem contemporânea. Inicia com o 'systemd', o moderno sistema de inicialização e gerenciamento de serviços que substituiu os scripts sequenciais do SysVinit: arquitetura orientada a dependências, ativação por socket, paralelização agressiva de boot e o conceito de Unidades (Units). Analisa os tipos fundamentais de unidades: serviços (.service), alvos de estado de execução (.target, substituindo runlevels), temporizadores (.timer, substitutos modernos do cron), pontos de montagem (.mount) e sockets (.socket). Domina os utilitários 'systemctl' e 'journalctl' para controle de ciclo de vida e auditoria de logs binários estruturados. Transita para a tecnologia que viabilizou contêineres como Docker, Podman e Kubernetes: a combinação de Cgroups e Namespaces no kernel. Disseca os Grupos de Controle (Control Groups - Cgroups v2): a hierarquia unificada de diretórios montada em '/sys/fs/cgroup' para medição, limitação e priorização estrita de recursos computacionais por grupos de processos: 'cpu.max' (limite de cotas de tempo de CPU por período), 'memory.max' (teto rígido de memória física), 'io.max' (limite de largura de banda e IOPS de disco) e 'pids.max' (prevenção contra ataques de exaustão tipo fork bombs). Analisa os Linux Namespaces: o recurso do kernel que isola recursos globais do sistema, fazendo com que processos enxerguem apenas seu próprio subconjunto: 1) PID namespace (isolamento de IDs de processos, com um PID 1 próprio dentro do namespace); 2) Mount namespace (pontos de montagem isolados); 3) Network namespace (interfaces de rede, tabelas de roteamento e portas exclusivas); 4) IPC namespace; 5) UTS namespace (hostname próprio); 6) User namespace (mapeamento de UID/GID não-root do host para UID 0 root dentro do namespace). Conclui demonstrando como construir um contêiner completo 'from scratch' através das chamadas 'clone', 'unshare' e 'pivot_root'.

10h
6

Célula 06: Pilha de Rede TCP/IP, Segurança do Kernel, Capabilities e Hardening

Consolidação dos subsistemas de comunicação em rede e da arquitetura de segurança, proteção e endurecimento (hardening) do kernel Linux em servidores de produção. Inicia com a Pilha de Rede TCP/IP no Kernel: a jornada de um pacote de rede desde a interrupção física da placa de rede (NIC), processamento por New API (NAPI) com pooling adaptativo, representação pela estrutura central 'sk_buff' (socket buffer) que atravessa as camadas de enlace, rede e transporte, até a entrega no buffer de recepção do socket POSIX em espaço de usuário. Explora o subsistema de filtragem Netfilter: os cinco hooks estratégicos no kernel (NF_INET_PRE_ROUTING, NF_INET_LOCAL_IN, NF_INET_FORWARD, NF_INET_LOCAL_OUT e NF_INET_POST_ROUTING). Analisa a arquitetura do 'nftables' (o moderno substituto unificado de iptables, ip6tables, arptables e ebtables) com máquinas virtuais de regras compactas e tabelas em memória, introduzindo o papel revolucionário do eBPF (Extended Berkeley Packet Filter) para filtragem de pacotes e observabilidade em velocidade de linha sem trocas de contexto. Transita para a Engenharia de Segurança e Privilégios Mínimos: a desconstrução do superusuário root 'tudo-ou-nada' através das Linux Capabilities (<sys/capability.h>): divisão dos privilégios em capacidades atômicas granulares como CAP_NET_BIND_SERVICE (ligar a portas privilegiadas < 1024), CAP_NET_ADMIN (administração de rede), CAP_SYS_ADMIN (operações administrativas gerais) e CAP_SYS_PTRACE, utilizando 'getcap' e 'setcap' para conceder poderes específicos a binários sem necessidade de 'suid root'. Investiga os Módulos de Segurança do Linux (LSM): arquitetura de ganchos (security hooks) que implementam Controle de Acesso Mandatório (Mandatory Access Control - MAC) acima do DAC tradicional. Compara em detalhes o SELinux (Security-Enhanced Linux: modelo centrado em Type Enforcement, contextos de segurança 'usuário:função:tipo:nível' e políticas estritas) e o AppArmor (modelo centrado em perfis associados a caminhos de arquivos executáveis com modos complain e enforce). Finaliza com Seccomp (Secure Computing Mode): restrição estrita de chamadas de sistema permitidas a um processo, mitigando ataques de exploração de vulnerabilidades no kernel.

10h