Pensamento Estratégico de Sustentabilidade para Gerentes de Projetos (Start)
História do pensamento sustentável, Agenda Pós-2030, ODS da ONU e ferramentas de análise climática em projetos.
Formação epistemológica, metodológica e analítica completa em delineamentos experimentais, quase-experimentais e observacionais, dimensionamento amostral com poder estatístico, psicometria avançada (TCT/TRI e análise fatorial confirmatória), análise exploratória robusta com tratamento de outliers e missings (MICE), modelos lineares generalizados (GLM), regressão multinível hierárquica (HLM), inferência causal moderna com grafos acíclicos dirigidos (DAGs), pareamento por escore de propensão (PSM) e reprodutibilidade aberta.
Do curso base em Pensamento Estratégico de Sustentabilidade (R$ 29,99) à Liderança Internacional em Projetos de Clima e Captação Global (R$ 199,99).
UPGRADE29) para abater nas Trilhas 2, 3, 4 ou 5!
História do pensamento sustentável, Agenda Pós-2030, ODS da ONU e ferramentas de análise climática em projetos.
Transição energética, bioeconomia, agronegócio regenerativo, Soluções Baseadas na Natureza (NbS) e infraestrutura resiliente.
Resolução CVM 193 (IFRS S1/S2), GRI, CSRD, fronteiras de carbono (CBAM), lei antidesmatamento (EUDR) e ACV/LCA.
Mercado regulado (SBCE) e voluntário de carbono, Green Bonds, Taxonomia Verde e captação no GCF, BID, IFC e Fundo Amazônia.
Metodologias globais PRiSM/GPM P5 e PMBOK 7, salvaguardas do IFC, inglês técnico executivo e certificações internacionais.
Sugestões ligadas ao conteúdo desta trilha para apoiar sua decisão de matrícula.
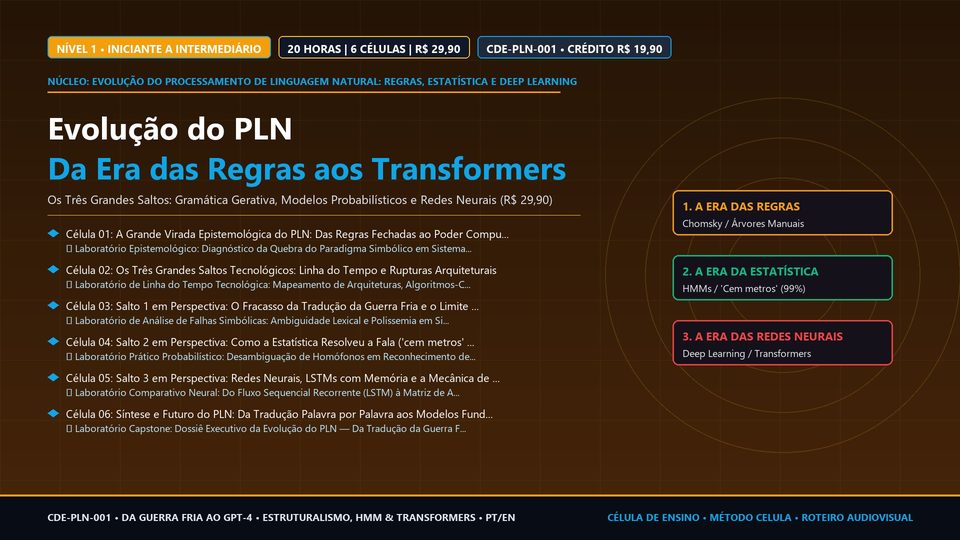
R$ 29,90
Compreenda como a ciência da computação abandonou a tentativa de ensinar regras gramaticais manuais às máquinas e passou a treiná-las com estatística massiva e redes neurais profundas através dos três grandes saltos do PLN.
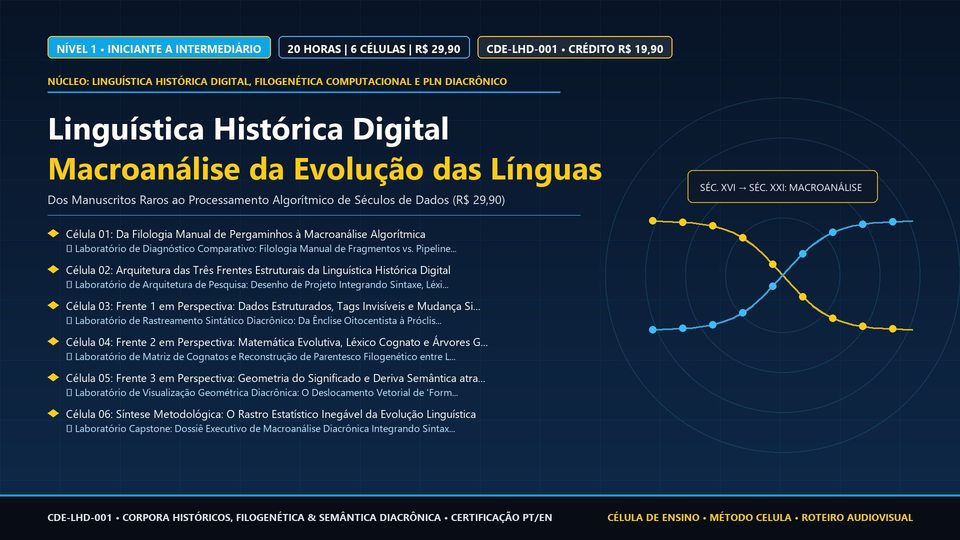
R$ 29,90
Compreenda como a transição da linguística histórica para o ambiente digital substituiu décadas de busca manual em pergaminhos pela macroanálise computacional em três frentes: corpora morfossintáticos, filogenética bayesiana e vetores semânticos diacrônicos.
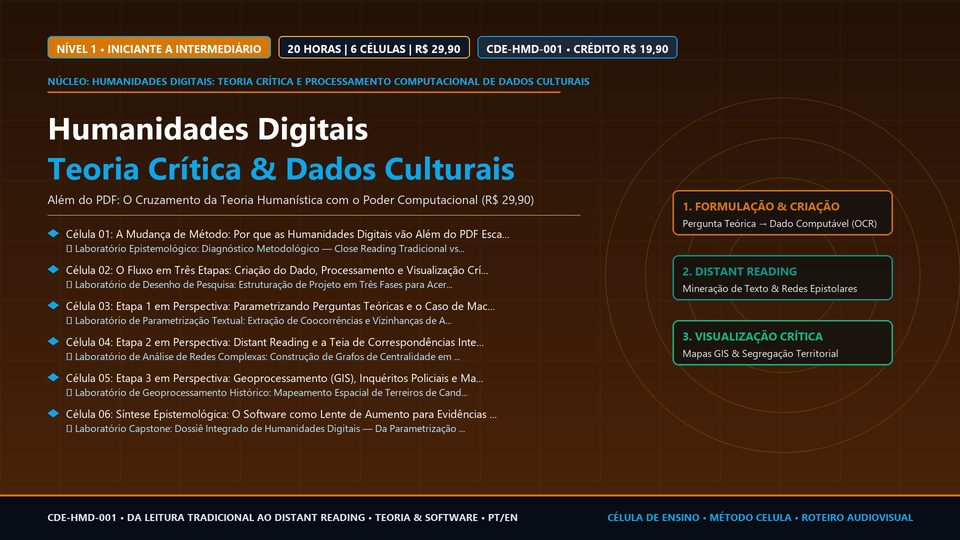
R$ 29,90
Compreenda por que as Humanidades Digitais não são apenas escanear livros em PDF, mas uma mudança de método que cruza teoria crítica e computação em três etapas: formulação da pergunta e criação do dado, processamento macroscópico e visualização crítica.
Estudo epistemológico e metodológico dos fundamentos da investigação científica e taxonomia dos delineamentos: 1. Filosofia da Ciência: indutivismo, falseacionismo popperiano (assimetria lógica entre verificação e refutação), paradigmas e quebras de paradigma kuhnianos, e realismo crítico; 2. Formulação de Hipóteses e Perguntas Científicas: hipótese nula (H0) vs alternativa (H1) bicaudal e monocaudal; frameworks PICO/PECO (População, Intervenção/Exposição, Comparador, Desfecho/Outcome) e critérios FINER (Exequível, Interessante, Inovadora, Ética, Relevante); 3. Taxonomia dos Delineamentos de Pesquisa: Delineamentos Experimentais: Ensaios Clínicos Randomizados (RCTs) padrão-ouro, variantes paralelos, cruzados (crossover com período de washout), fatoriais 2x2 para avaliação de interação, e em cluster (conglomerados comunitários/hospitalares); técnicas de randomização (simples, em blocos permutados, estratificada e adaptativa) e mascaramento (simples, duplo e triplo-cego); 4. Delineamentos Quase-Experimentais: estudos sem randomização completa mas com controle de contrafactual: regressão em descontinuidade (RDD), séries temporais interrompidas (ITS) e diferenças em diferenças (DiD); 5. Delineamentos Observacionais Analíticos: Coorte prospectiva e retrospectiva (cálculo de Risco Relativo - RR e incidência acumulada), Caso-Controle pareado (cálculo de Odds Ratio - OR para eventos raros e viés de memória), e Transversais / Cross-sectional (cálculo de Razão de Prevalência - RP); e 6. Vieses Epidemiológicos e Rigor Metodológico: viés de seleção (viés de Berkson, viés do voluntário sadio), viés de aferição/informação (viés de memória, efeito Hawthorne) e viés de confusão; o movimento de Ciência Aberta e o combate ao p-hacking, HARKing (Hypothesizing After the Results are Known) e efeito gaveta através do pré-registro obrigatório de protocolos em plataformas abertas (OSF, ClinicalTrials.gov, PROSPERO).
10hEstudo teórico e computacional da amostragem, dimensionamento amostral, teoria da decisão estatística e matriz de validades: 1. Teoria da Amostragem: população-alvo, população acessível e fração de amostragem; Amostragem Probabilística: Aleatória Simples com e sem reposição, Estratificada com alocação proporcional e alocação ótima de Neyman (minimização da variância para custo fixo), por Conglomerados em Estágios Múltiplos com cálculo do Efeito de Desenho (Design Effect - DEFF = 1 + (m - 1)*ICC) e Amostragem Sistemática com intervalo k; Amostragem Não Probabilística: por conveniência, cotas proporcionais, amostragem intencional por julgamento e técnica Snowball (bola de neve com amostragem orientada pelo respondente - RDS para populações ocultas); 2. Teorema Central do Limite (TCL) e Distribuição Amostral das Médias e Proporções; Erro Padrão da Média (SE = sigma / sqrt(n)); 3. Cálculo de Tamanho Amostral: equações clássicas para estimação de médias contínuas e proporções com erro amostral tolerável (e), nível de confiança (1 - alpha) e correção para populações finitas; dimensionamento para testes de hipóteses de duas médias independentes e proporções; 4. Teoria da Decisão Estatística e Poder: Erro Tipo I (alpha, taxa de falsos positivos, nível de significância usual de 0,05), Erro Tipo II (beta, taxa de falsos negativos) e Poder Estatístico (1 - beta, probabilidade de detectar um efeito verdadeiro, recomendado >= 0,80 ou 0,90); Tamanhos de Efeito Padronizados (Effect Sizes): d de Cohen e g de Hedges (diferença padronizada de médias), r de Pearson, Odds Ratio, Risco Relativo e eta-quadrado parcial (eta_p^2); 5. Análise de Poder Computacional no G*Power e R (pacote pwr): análise a priori (cálculo de n dado alpha, power e effect size), análise post-hoc (cálculo do poder observado dado n e alpha - limitações e controvérsias) e análise de sensibilidade (menor efeito detectável dado n e power); e 6. A Matriz das Quatro Validades de Campbell e Cook: Validade Estatística de Conclusão (pressupostos, poder e violação de alpha), Validade Interna (confundimento, história, maturação e regressão à média), Validade de Construto (operacionalização de variáveis e viés de monométodo) e Validade Externa (generalização populacional e validade ecológica temporal).
10hEstudo epistemológico e estatístico da psicometria, teoria da mensuração latente e validação transcultural de escalas: 1. Teoria da Mensuração: construtos latentes (não observáveis diretamente, como ansiedade, qualidade de vida, engajamento ou estresse) vs indicadores operacionais observáveis; tipos de escalas psicométricas (Likert de 5 e 7 pontos, diferencial semântico de Osgood, escalas visuais analógicas - VAS e escala de Guttman cumulativa); 2. Teoria Clássica dos Testes (TCT): o modelo linear do escore verdadeiro de Spearman (X = T + E, onde X é o escore observado, T é o escore verdadeiro e E é o erro aleatório de medida); pressupostos de erros não correlacionados; 3. Teoria de Resposta ao Item (TRI / IRT): modelos logísticos de Rasch (1 parâmetro: dificuldade do item b), 2 parâmetros (dificuldade b e discriminação do item a) e 3 parâmetros (incluindo acerto casual c); Curva Característica do Item (CCI) e Função de Informação do Teste (FIT); 4. Adaptação Transcultural de Instrumentos: diretrizes internacionais (Beaton et al., ITC): tradução direta independente, síntese consensual, retrotradução (back-translation) cega por nativos, avaliação por comitê multidisciplinar de juízes e pré-teste cognitivo (debriefing); 5. Avaliação da Fidedignidade / Precisão: Consistência Interna com Alfa de Cronbach (alpha - limitações e vulnerabilidade ao número de itens e tau-equivalência) vs Ômega de McDonald (omega hierárquico e total para cargas fatoriais heterogêneas); Estabilidade Temporal via Teste-Reteste com Coeficiente de Correlação Intraclasse (ICC modelos two-way mixed/random); Concordância Interobservadores via Coeficiente Kappa de Cohen (kappa não ponderado e ponderado quadrático de Fleiss); e 6. Validação de Construto e Dimensionalidade: Validade de Conteúdo pelo Índice de Validade de Conteúdo (CVI / IVC >= 0,80); Análise Fatorial Exploratória (AFE): teste de esfericidade de Bartlett, índice KMO (Kaiser-Meyer-Olkin > 0,70), métodos de extração (Principal Axis Factoring, Maximum Likelihood) e rotações oblíquas (Promax, Direct Oblimin) vs ortogonais (Varimax); Análise Fatorial Confirmatória (AFC) via Modelagem de Equações Estruturais (SEM): índices globais de ajuste (Chi-quadrado/df < 3, RMSEA < 0,06 com IC90%, CFI e TLI > 0,95, SRMR < 0,08); e Validade Convergente e Discriminante pelos critérios de Fornell-Larcker (VME / AVE > 0,50) e razão HTMT (Heterotrait-Monotrait Ratio < 0,85).
10hEstudo aprofundado do ciclo da Análise Exploratória de Dados (AED / EDA), diagnóstico de qualidade de dados e fundamentos da inferência paramétrica e não paramétrica: 1. Tipologia e Níveis de Mensuração de Variáveis: escalas qualitativas nominais (binárias e politômicas) e ordinais; escalas quantitativas discretas e contínuas (intervalares e de razão com zero absoluto); 2. Estatística Descritiva Clássica e Robusta: medidas de tendência central sensíveis vs resistentes a valores extremos (média aritmética vs média aparada a 5% e 10%, mediana e moda); medidas de dispersão (variância, desvio padrão, coeficiente de variação de Pearson - CV%, amplitude interquartil - IQR e desvio absoluto da mediana - MAD); assimetria (skewness) e curtose (kurtosis); 3. Detecção e Manejo de Outliers (Valores Atípicos): escores Z clássicos vs escores Z robustos (baseados na mediana e MAD); regra de Tukey (limites do boxplot: Q1 - 1,5*IQR e Q3 + 1,5*IQR); identificação multivariada de outliers via Distância de Mahalanobis com distribuição Chi-quadrado; estratégias de tratamento (winsorização, transformação matemática log/Box-Cox ou remoção fundamentada); 4. Teoria e Tratamento de Dados Faltantes (Missing Data): taxonomia de Rubin: Faltantes Completamente ao Acaso (MCAR - Missing Completely at Random), Faltantes ao Acaso condicionados a covariáveis (MAR - Missing at Random) e Faltantes Não ao Acaso dependentes do próprio valor ausente (MNAR - Missing Not at Random); teste de MCAR de Little; os graves perigos da exclusão por lista (listwise deletion) e da imputação pela média; o padrão-ouro metodológico: Imputação Múltipla por Equações Encadeadas (MICE - Multiple Imputation by Chained Equations) e pooling pelas regras de Rubin; 5. Verificação dos Pressupostos Paramétricos Clássicos: Normalidade (testes de Shapiro-Wilk, Kolmogorov-Smirnov com correção de Lilliefors, gráficos Q-Q plot de resíduos); Homocedasticidade / Homogeneidade de Variâncias (teste de Levene robusto pela mediana e teste de Bartlett); e 6. Árvore de Decisão Inferencial Bivariada: Comparação de 2 Grupos: Teste t de Student para amostras independentes com correção de Welch para variâncias desiguais vs Teste U de Mann-Whitney (Wilcoxon rank-sum); Teste t pareado vs Teste de Postos Sinalizados de Wilcoxon; Comparação de 3 ou mais Grupos: ANOVA unifatorial (One-Way) com testes post-hoc de Tukey HSD, Bonferroni e Games-Howell vs Kruskal-Wallis com post-hoc de Dunn-Bonferroni; ANOVA de Medidas Repetidas com teste de esfericidade de Mauchly e correções de Greenhouse-Geisser/Huynh-Feldt vs Teste de Friedman; e Associação Categórica: Teste de Qui-Quadrado de Independência (Pearson Chi-Square), teste exato de Fisher e V de Cramér.
10hEstudo teórico e prático da modelagem multivariada avançada, Modelos Lineares Generalizados (GLM) e Modelos Mistos Hierárquicos (HLM / LMM): 1. Arquitetura dos Modelos Lineares Generalizados (GLM): componente aleatório (distribuições da família exponencial: Gaussiana, Binomial, Poisson, Gama, Binomial Negativa), componente sistemático (preditor linear eta = beta_0 + beta_1*X_1 + ...) e função de ligação link g(mu) = eta (identidade, logit, log, probit); 2. Regressão Linear Múltipla: estimação por Mínimos Quadrados Ordinários (OLS); coeficientes de regressão não padronizados (B) e coeficientes padronizados (beta); Coeficiente de Determinação (R^2 e R^2 ajustado para penalização de preditores); diagnóstico de resíduos: linearidade, normalidade dos resíduos, homocedasticidade (teste de Breusch-Pagan / Koenker), independência (estatística de Durbin-Watson) e avaliação estrita de Multicolinearidade através do Fator de Inflação da Variância (VIF < 5 ou 10) e Tolerance; 3. Regressão Logística Binária e Multinomial: modelagem de desfechos dicotômicos; função sigmoide e transformação logit (log-odds); interpretação de coeficientes via Odds Ratio ajustado (OR = e^beta) e seus intervalos de confiança de 95%; teste de calibração de Hosmer-Lemeshow; capacidade discriminatória e acurácia clínica via Curva ROC (Receiver Operating Characteristic), Área sob a Curva (AUC / C-statistic), sensibilidade, especificidade e índice de Youden; 4. Modelos para Dados de Contagem: Regressão de Poisson (premissa de equidispersão: média = variância) vs Regressão Binomial Negativa para acomodação de sobredispersão (overdispersion); Modelos Inflacionados de Zero (Zero-Inflated Poisson / ZIP); e 5. Modelos Lineares Mistos Hierárquicos / Multinível (HLM / LMM) e Dados Longitudinais: estruturas de dados aninhados (alunos em turmas, turmas em escolas, pacientes em hospitais) e medidas repetidas ao longo do tempo (indivíduo como cluster de suas próprias avaliações); violação do pressuposto de independência de erros; separação da variância intra-grupo (nível 1) e entre-grupos (nível 2); Coeficiente de Correlação Intraclasse (ICC = tau_00 / (tau_00 + sigma^2)); Modelos com Intercepto Aleatório (Random Intercept) vs Inclinação Aleatória (Random Slope); estimadores de Máxima Verossimilhança Restrita (REML) vs Máxima Verossimilhança Completa (ML); e seleção de modelos parcimoniosos baseada nos Critérios de Informação de Akaike (AIC) e Bayesiano (BIC).
10hEstudo dos fundamentos epistemológicos e matemáticos da Inferência Causal contemporânea, métodos quase-experimentais e princípios de Ciência Aberta e Reprodutibilidade: 1. A Revolução Causal: superação do aforismo 'correlação não implica causalidade' pela formalização de modelos causais identificáveis; Modelo de Resultados Potenciais de Rubin (Rubin Causal Model - RCM): contrafactuais, Efeito Causal Médio (ATE - Average Treatment Effect) e Efeito Causal nos Tratados (ATT - Average Treatment Effect on the Treated); pressupostos de identificação causal: Ignorabilidade / Trocaabilidade (Exchangeability), Positividade (Positivity: 0 < P(X=1|Z) < 1) e Consistência (SUTVA - Stable Unit Treatment Value Assumption: sem interferência e sem múltiplas versões do tratamento); 2. Teoria Causal Estrutural de Judea Pearl: Grafos Acíclicos Dirigidos (DAGs - Directed Acyclic Graphs); terminologia gráfica: nós (variáveis), arestas orientadas (caminhos causais), pais, filhos, ancestrais e descendentes; conceitos fundamentais de fluxo de dependência: Cadeias causais (X -> M -> Y: mediação), Garfos (X <- Z -> Y: confundimento) e Colisores (X -> C <- Y: colisão); o princípio da d-separação (d-separation); o Viés de Colisor (Collider Stratification Bias / Viés de Berkson / Paradoxo de Berkson): condicionar em um colisor comum abre artificialmente uma associação espúria entre suas causas não relacionadas; 3. O Critério da Porta dos Fundos (Backdoor Criterion): definição do Conjunto Mínimo Suficiente de Ajuste (Minimal Sufficient Adjustment Set); por que controlar por variáveis intermediárias (mediadores) comete 'superajuste' (overcontrolling) e neutraliza o efeito causal total; 4. Métodos Avançados de Inferência Causal em Dados Observacionais: Pareamento por Escore de Propensão (Propensity Score Matching - PSM): cálculo do escore via regressão logística ou machine learning, algoritmos de pareamento (Nearest Neighbor com calibrador/caliper, Optimal Matching), diagnóstico de balanceamento de covariáveis com Diferença Média Padronizada (SMD < 0,10); Ponderação por Probabilidade Inversa de Tratamento (IPTW - Inverse Probability of Treatment Weighting) e escores estabilizados; Variáveis Instrumentais (IV / 2SLS) para controle de confusão não mensurada e endogeneidade; e Regressão em Descontinuidade (RDD); e 5. Ciência Aberta, Reprodutibilidade e Diretrizes de Relato: diretrizes de publicação padronizadas EQUATOR Network: CONSORT para Ensaios Clínicos Randomizados, STROBE para Estudos Observacionais, e PRISMA para Revisões Sistemáticas e Metanálises; princípios FAIR (Findable, Accessible, Interoperable, Reusable) para dados de pesquisa; relatórios computacionais reproduzíveis (RMarkdown, Quarto, Jupyter); e compartilhamento de códigos e dados brutos em repositórios abertos (Zenodo, Harvard Dataverse, OSF).
10h