Pensamento Estratégico de Sustentabilidade para Gerentes de Projetos (Start)
História do pensamento sustentável, Agenda Pós-2030, ODS da ONU e ferramentas de análise climática em projetos.
Formação aprofundada e rigorosa em engenharia e arquitetura de sistemas distribuídos para processamento massivo de dados (Big Data e Data Engineering). Investiga os fundamentos teóricos da computação distribuída, o Teorema CAP e o modelo PACELC, os modelos de consistência de dados e o paradigma clássico MapReduce com o sistema de arquivos distribuídos HDFS. Disseca o processamento em lote (Batch) de alto desempenho com o ecossistema Apache Spark, dominando as abstrações de RDDs, grafos de linhagem (DAG), otimizações de plano lógico e físico com o Catalyst Optimizer e o motor de memória off-heap Project Tungsten. Explora a ingestão e mensageria em tempo real em escala petabyte com Apache Kafka, abordando a anatomia do log de commit distribuído particionado, o protocolo de consenso KRaft, semânticas de entrega Exactly-Once (EOS), rebalanceamento cooperativo de consumidores e governança de esquemas via Schema Registry e Apache Avro. Mergulha na computação orientada a fluxos contínuos (Stream Processing) de baixa latência e alta vazão com Apache Flink, dominando Event Time versus Processing Time, Watermarks para dados desordenados, janelas temporais dinâmicas, gerenciamento de estado distribuído com RocksDB e tolerância a falhas via algoritmo de snapshot distribuído assíncrono Chandy-Lamport. Compara detalhadamente a evolução dos padrões arquiteturais (Arquitetura Lambda versus Arquitetura Kappa) e a revolução dos Data Lakehouses com formatos colunares abertos transacionais (Apache Iceberg e Delta Lake), proporcionando transações ACID, Time-Travel e evolução de esquemas sobre object storage em conjunto com os princípios de Data Mesh federado. Conclui com as melhores práticas de DataOps: orquestração robusta de pipelines analíticos com Apache Airflow, modelagem e transformação modular com dbt (data build tool), validação automatizada de qualidade com Great Expectations e observabilidade ponta a ponta com OpenLineage.
Do curso base em Pensamento Estratégico de Sustentabilidade (R$ 29,99) à Liderança Internacional em Projetos de Clima e Captação Global (R$ 199,99).
UPGRADE29) para abater nas Trilhas 2, 3, 4 ou 5!
História do pensamento sustentável, Agenda Pós-2030, ODS da ONU e ferramentas de análise climática em projetos.
Transição energética, bioeconomia, agronegócio regenerativo, Soluções Baseadas na Natureza (NbS) e infraestrutura resiliente.
Resolução CVM 193 (IFRS S1/S2), GRI, CSRD, fronteiras de carbono (CBAM), lei antidesmatamento (EUDR) e ACV/LCA.
Mercado regulado (SBCE) e voluntário de carbono, Green Bonds, Taxonomia Verde e captação no GCF, BID, IFC e Fundo Amazônia.
Metodologias globais PRiSM/GPM P5 e PMBOK 7, salvaguardas do IFC, inglês técnico executivo e certificações internacionais.
Sugestões ligadas ao conteúdo desta trilha para apoiar sua decisão de matrícula.
R$ 29,90
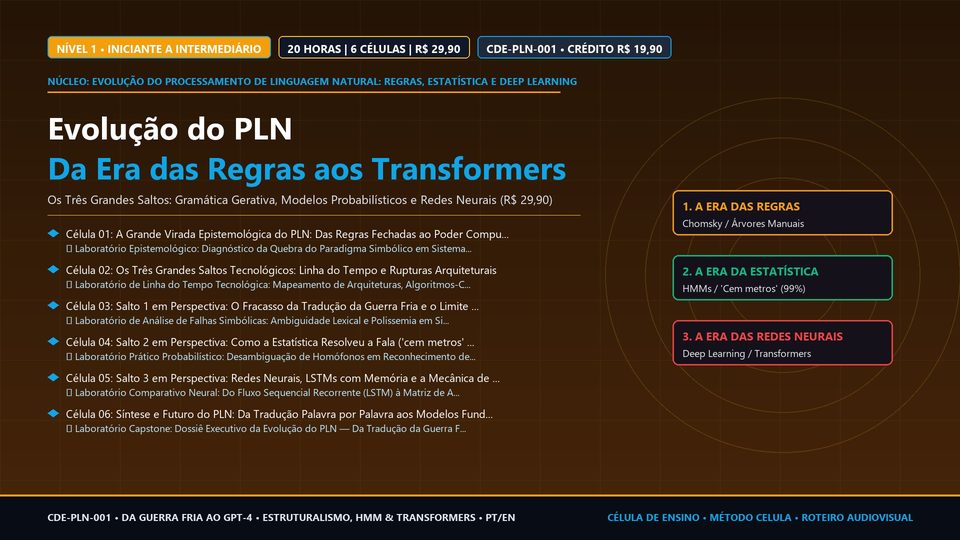
Compreenda como a ciência da computação abandonou a tentativa de ensinar regras gramaticais manuais às máquinas e passou a treiná-las com estatística massiva e redes neurais profundas através dos três grandes saltos do PLN.
R$ 29,90
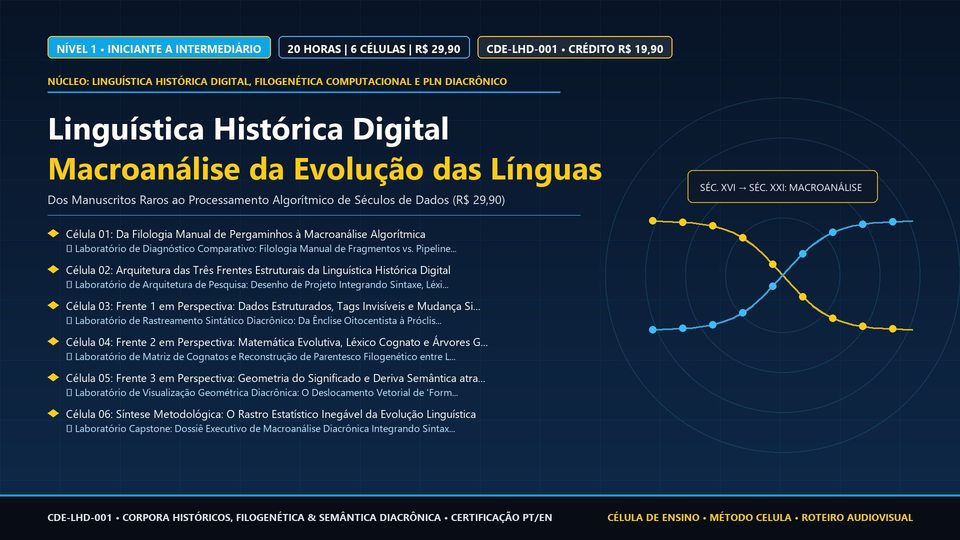
Compreenda como a transição da linguística histórica para o ambiente digital substituiu décadas de busca manual em pergaminhos pela macroanálise computacional em três frentes: corpora morfossintáticos, filogenética bayesiana e vetores semânticos diacrônicos.
R$ 29,90
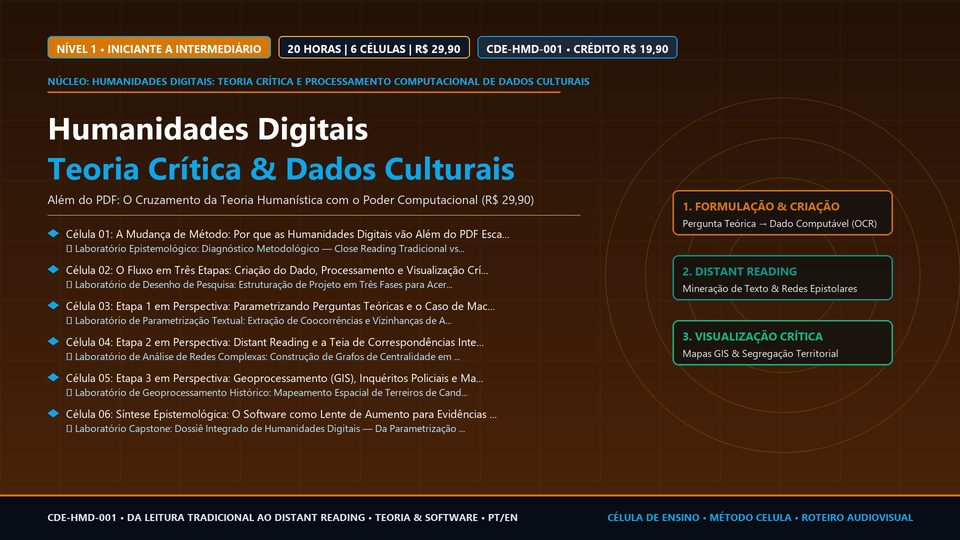
Compreenda por que as Humanidades Digitais não são apenas escanear livros em PDF, mas uma mudança de método que cruza teoria crítica e computação em três etapas: formulação da pergunta e criação do dado, processamento macroscópico e visualização crítica.
Fundamentos teóricos e algorítmicos da computação distribuída aplicada ao processamento massivo de dados. Analisa as propriedades fundamentais de sistemas descentralizados: falhas parciais de hardware, ausência de relógio global e latências não determinísticas de rede. Disseca formalmente o Teorema CAP de Eric Brewer (Consistência, Disponibilidade e Tolerância a Particionamento) e a formulação expandida PACELC de Daniel Abadi, distinguindo garantias de consistência estrita (Linearizability, Sequential Consistency) de consistência eventual e modelos de isolamento de leitura/escrita. Investiga a arquitetura de armazenamento distribuído em larga escala exemplificada pelo Google File System (GFS) e sua implementação de código aberto Hadoop Distributed File System (HDFS): separação de metadados no NameNode, distribuição de blocos de dados em DataNodes, estratégias de replicação com consciência de rack (rack awareness) e mecanismos de heartbeat e re-replicação automática. Examina o paradigma algorítmico MapReduce introduzido por Jeffrey Dean e Sanjay Ghemawat: abstração de funções puras de ordem superior (map e reduce), fluxo determinístico de dados através das etapas de Map, Partitioning por hash, Shuffling de rede e Sorting intermediário antes da redução final. Analisa as limitações arquiteturais do MapReduce clássico: dependência excessiva de I/O em disco magnético, overhead de serialização e ineficiência severa para algoritmos iterativos de grafos e aprendizado de máquina.
10hArquitetura e engenharia de execução do Apache Spark para processamento batch em memória (in-memory computing). Explora a abstração seminal do RDD (Resilient Distributed Dataset): imutabilidade, coleções de objetos particionadas entre executores, avaliação preguiçosa (lazy evaluation) e rastreamento de linhagem de transformações por meio de um Grafo Acíclico Dirigido (Lineage DAG). Diferencia transformações de dependência estreita (narrow dependencies: map, filter) executadas em pipeline na mesma partição de memória daquelas de dependência ampla (wide dependencies: groupByKey, reduceByKey, join) que exigem transferência de dados através da rede física (shuffle boundary). Disseca o Spark SQL Engine e as abstrações de alto nível DataFrames e Datasets com esquemas tipados. Examina a fundo os mecanismos internos do Catalyst Optimizer: otimização de árvore de sintaxe abstrata (AST), análise semântica, otimizações lógicas rule-based e cost-based (pushdown de predicados, projeção colunar, reordenação de joins) e seleção de plano físico de execução. Analisa o motor de execução física Project Tungsten: gerenciamento de memória fora da JVM (off-heap memory) para eliminar pausas imprevisíveis de Garbage Collection, layout binário compacto de objetos de dados colunares e geração de código compilado em runtime por estágio completo (whole-stage code generation). Aborda técnicas avançadas de performance: mitigação de data skew com salting de chaves, particionamento customizado por hash/range, broadcast hash joins e estratégias de persistência em cache e disco.
10hEngenharia de infraestrutura de mensageria distribuída de alta vazão e baixa latência com o ecossistema Apache Kafka. Analisa o paradigma de log de commit distribuído append-only e imutável como espinha dorsal de Arquiteturas Orientadas a Eventos (Event-Driven Architectures). Disseca a anatomia de um cluster Kafka: tópicos lógicos, partições físicas como unidades fundamentais de paralelismo e escalabilidade horizontal, estruturas de arquivos de log segmentados em disco com zero-copy transfer (sendfile do Linux kernel), índices esparsos de offset e retenção baseada em tempo e tamanho. Examina os mecanismos de alta disponibilidade e consenso: eleição de réplicas líderes, conjunto de réplicas em sincronia (ISR - In-Sync Replicas), parâmetros de confirmação (acks=0, acks=1, acks=all/min.insync.replicas) e a transição arquitetural do Apache ZooKeeper para o protocolo de metadados nativo baseado em Raft (KRaft mode). Investiga rigorosamente os modelos de semântica de entrega: At-least-once, At-most-once e Exactly-Once Semantics (EOS), compreendendo o funcionamento de produtores idempotentes com números de sequência por produtor e transações distribuídas atômicas de escrita coordenada de múltiplos tópicos e offsets de leitura (two-phase commit). Estuda os padrões de consumo distribuído: grupos de consumidores (Consumer Groups), partição estática versus rebalanceamento cooperativo incremental (Cooperative Sticky Assignor) para eliminação de pausas 'stop-the-world'. Aborda a governança e evolução de esquemas de dados através do Confluent Schema Registry e serialização Apache Avro com regras estritas de compatibilidade (Backward, Forward, Full).
10hEngenharia de processamento de fluxos contínuos e não limitados (unbounded streams) orientados a eventos com o motor Apache Flink. Estabelece a distinção epistemológica e prática entre as noções temporais: Event Time (momento em que o fato ocorreu no cliente/sensor), Ingestion Time (momento de entrada no cluster de mensageria) e Processing Time (relógio local da máquina executora do pipeline). Disseca o mecanismo de Watermarks para o progresso do tempo do evento em ambientes assíncronos: geração periódica e pontuada, estratégias heurísticas para tratamento de dados fora de ordem (bounded-out-of-orderness) e políticas de descarte ou desvio de dados excessivamente atrasados (late data) via side outputs. Explora a taxonomia de janelas temporais: janelas de tombamento (tumbling windows), janelas deslizantes (sliding windows) e janelas de sessão baseadas em inatividade (session windows) com funções de agregação incremental (AggregateFunction, ReduceFunction) e funções completas de janela (ProcessWindowFunction). Investiga o gerenciamento de estado distribuído de alta escala (Stateful Stream Processing): tipos de estado gerenciado por chave (ValueState, ListState, MapState) e backends de estado (HashMapStateBackend em memória heap da JVM versus EmbeddedRocksDBStateBackend baseado em LSM-trees em armazenamento local NVMe off-heap). Analisa formalmente o algoritmo de tolerância a falhas do Flink: snapshots distribuídos assíncronos baseados no algoritmo seminal de Chandy-Lamport, injeção de barreiras de checkpoint no fluxo de dados, alinhamento de barreiras (barrier alignment vs unaligned checkpoints) e restauração determinística de estado exato (Savepoints) para evolução de topologia e manutenção sem perda de dados.
10hEvolução histórica, comparação de paradigmas e implementação de arquiteturas modernas de plataformas de dados corporativos. Analisa detalhadamente a Arquitetura Lambda proposta por Nathan Marz: a segregação entre a camada em lote (Batch Layer com HDFS/Spark para precisão e reprocessamento histórico completo), a camada de velocidade (Speed Layer com Storm/Flink para baixa latência) e a camada de serviço (Serving Layer com bancos NoSQL como HBase ou Cassandra para fusão das visões). Disseca as limitações operacionais da Arquitetura Lambda: a infame duplicidade de lógica de negócio em bases de código distintas (ex: Java para MapReduce e Scala/Clojure para streaming), custos operacionais duplicados e inconsistências temporais nas consultas analíticas. Examina a superação da Lambda pela Arquitetura Kappa proposta por Jay Kreps: eliminação da camada batch tradicional, adoção de um log imutável de eventos como fonte única da verdade e reprocessamento histórico efetuado através do replay de streams de dados a partir de offsets passados. Investiga a revolução dos Data Lakehouses: a convergência entre a flexibilidade e baixo custo de armazenamento de objetos em nuvem (Amazon S3, Azure Data Lake Storage Gen2, Google Cloud Storage) e as garantias transacionais de Data Warehouses corporativos. Analisa a fundo os novos formatos de tabela aberta: Apache Iceberg, Delta Lake e Apache Hudi. Estuda a camada de metadados transacionais (snapshot isolation, manifest files, commit logs JSON/Avro), suporte a transações ACID concorrentes sem bloqueio global, capacidades avançadas de Time-Travel (consultas a versões históricas pontuais da tabela) e evolução in-place de esquemas e particionamento (hidden partitioning). Discute os princípios organizacionais do Data Mesh teorizados por Zhamak Dehghani: descentralização da propriedade de dados orientada a domínios de negócio, dados como produto (Data as a Product), plataforma de infraestrutura de dados de autosserviço e governança computacional federada.
10hPráticas avançadas de engenharia de software aplicadas a dados (DataOps), focando na confiabilidade, qualidade contínua, governança e orquestração de pipelines em ambientes de produção. Disseca a orquestração programática de fluxos de trabalho com Apache Airflow: representação de pipelines como Grafos Acíclicos Dirigidos (DAGs) puramente declarados em código Python, ciclo de vida das tarefas (task lifecycle e estados), operadores padrão e operadores conteinerizados (KubernetesPodOperator), sensores assíncronos (async sensors/deferrable operators), passagem de estado leve com XCom e prevenção de sobrecarga do Airflow Scheduler. Investiga o paradigma ELT moderno e a engenharia de transformação com dbt (data build tool): separação entre carregamento e transformação, modelagem dimensional em camadas de dados (Staging, Intermediate, Marts segundo metodologia de Ralph Kimball), linhagem de dependências calculada automaticamente (dbt DAG), compilação de código Jinja/SQL em modelos efêmeros, visões e tabelas incrementais materializadas com estratégias de merge. Examina a garantia de integridade e qualidade de dados através de testes declarativos com dbt-test e frameworks dedicados como Great Expectations: definição de contratos de dados (expectations de preenchimento, cardinalidade, unicidade e regras de negócio) executados de forma automatizada no pipeline de ingestão com bloqueio imediato (circuit breaker) de cargas corrompidas. Explora a observabilidade moderna de dados (Data Observability): os cinco pilares fundamentais da confiabilidade analítica (Freshness/Frescura, Volume, Schema Drift/Mudança de Esquema, Linhagem e Qualidade/Anomalias), rastreamento padronizado de linhagem ponta a ponta com a especificação aberta OpenLineage e integração de alertas proativos em canais de incident response.
10h