Célula de Ensino evolução que gera resultados
Hardware para IA, Arquitetura de Computadores e Infraestrutura Local

Curso Completo: Montagem de Computadores para Inteligência Artificial

O curso leva o aluno de nunca ter aberto um gabinete até projetar, montar e otimizar estações de IA com múltiplas GPUs, em 4 níveis e 120 horas (com 40% de bancada prática). Ensina a selecionar componentes pelo prisma da IA — onde VRAM e barramentos guiam as decisões —, configurar a stack de drivers, CUDA, contêineres e modelos locais (LLMs, ComfyUI, LoRA), medir benchmarks reais e calcular o TCO entre infraestrutura local e nuvem.

57 células 120h Iniciante a Expert
🚀 Escada de Valor • Pacotes & Credit Upgrade (R$ 29,99 a R$ 199,99)

Jornada Executiva: Engenharia de Hardware, Arquitetura de Computadores & Microeletrônica

Do curso base em Engenharia de Hardware (R$ 29,99) ao Master Internacional em Arquitetura de Processadores & RISC-V (R$ 199,99).

🎯 1. Porta de Entrada (R$ 29,99) Inicie pela Trilha Start (R$ 29,99) com baixo atrito financeiro e domine os fundamentos globais na prática.
💳 2. Abatimento no Upgrade (Credit Upgrade) 100% dos R$ 29,99 investidos na Trilha Start viram crédito imediato (cupom CHE29) para abater nas Trilhas 2, 3, 4 ou 5!
🌍 3. Certificação Dupla (PT-BR & EN) + ODS Certificados emitidos em Português e Inglês com competências alinhadas aos ODS da ONU para seu perfil global no LinkedIn.
Alinhamento ONU / Agenda Pós-2030: ODS 9 (Indústria, Inovação e Infraestrutura) ODS 4 (Educação Superior de Qualidade) ODS 8 (Trabalho Decente) ODS 17 (Parcerias Globais)
Nível 1 • 6h

Engenharia de Hardware de Computador: De C e Assembly à Microarquitetura e Multicore (Start)

Programação C de baixo nível, ponteiros e pilha, linguagem assembly e código de máquina, sistemas de E/S com interrupções e MMIO, design digital combinatório e sequencial, ULA e caminho de dados do processador, pipeline com tratamento de hazards, hierarquias de memória cache (I-cache/D-cache) e virtual, Lei de Amdahl e paralelismo multicore.

R$ 29,99 Gera R$ 29,99 em crédito de upgrade
Ver Trilha →
Sugestões CdE

Compare com trilhas semelhantes

Sugestões ligadas ao conteúdo desta trilha para apoiar sua decisão de matrícula.

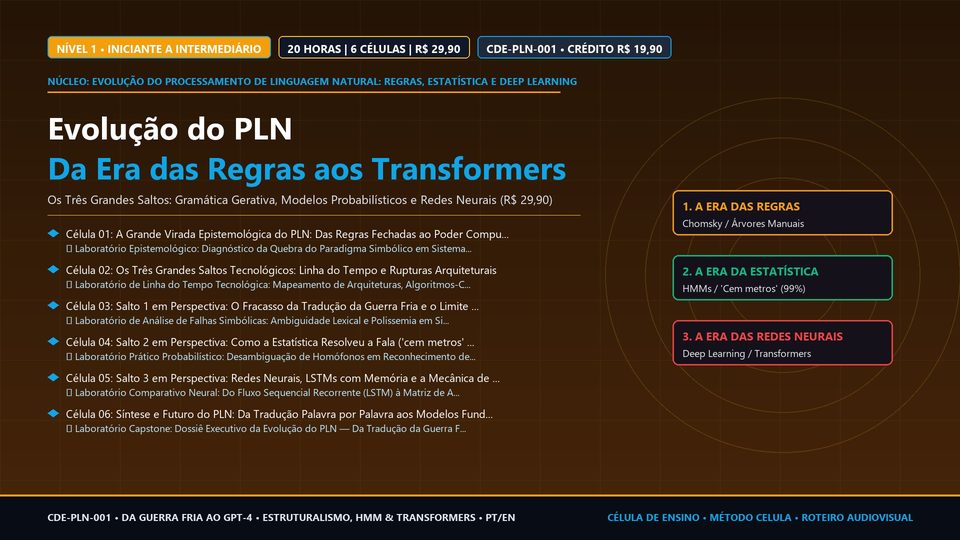
Evolução do Processamento de Linguagem Natural: Da Era das Regras Simbólicas à Estatística Massiva e à Atenção dos Transformers R$ 29,90
Evolução do Processamento de Linguagem Natural: Regras, Estatística e Deep Learning

Evolução do Processamento de Linguagem Natural: Da Era das Regras Simbólicas à Estatística Massiva e à Atenção dos Transformers

Compreenda como a ciência da computação abandonou a tentativa de ensinar regras gramaticais manuais às máquinas e passou a treiná-las com estatística massiva e redes neurais profundas através dos três grandes saltos do PLN.

📚 12 células ⏱️ 20h Iniciante a Intermediário
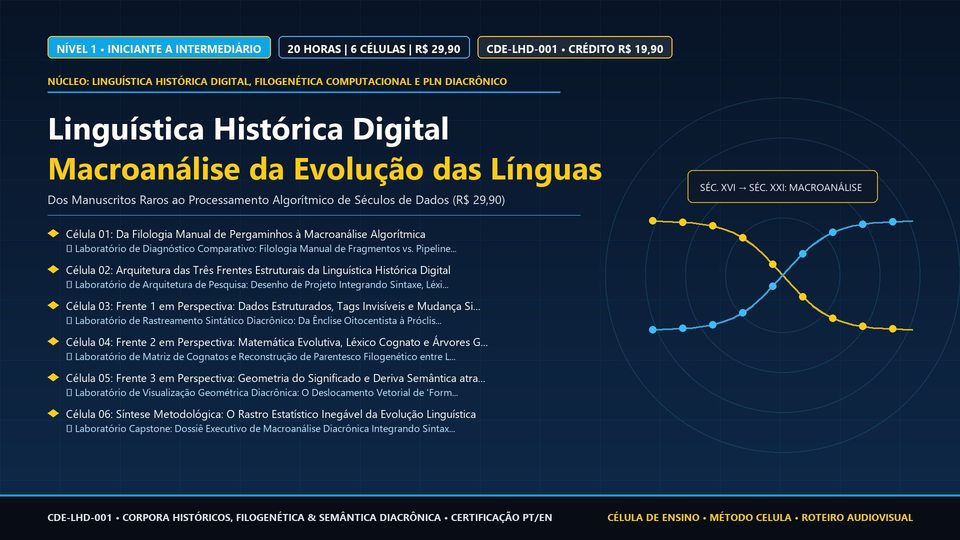
Linguística Histórica Digital: Da Filologia de Manuscritos à Macroanálise Computacional da Evolução das Línguas R$ 29,90
Linguística Histórica Digital, Filogenética Computacional e PLN Diacrônico

Linguística Histórica Digital: Da Filologia de Manuscritos à Macroanálise Computacional da Evolução das Línguas

Compreenda como a transição da linguística histórica para o ambiente digital substituiu décadas de busca manual em pergaminhos pela macroanálise computacional em três frentes: corpora morfossintáticos, filogenética bayesiana e vetores semânticos diacrônicos.

📚 12 células ⏱️ 20h Iniciante a Intermediário
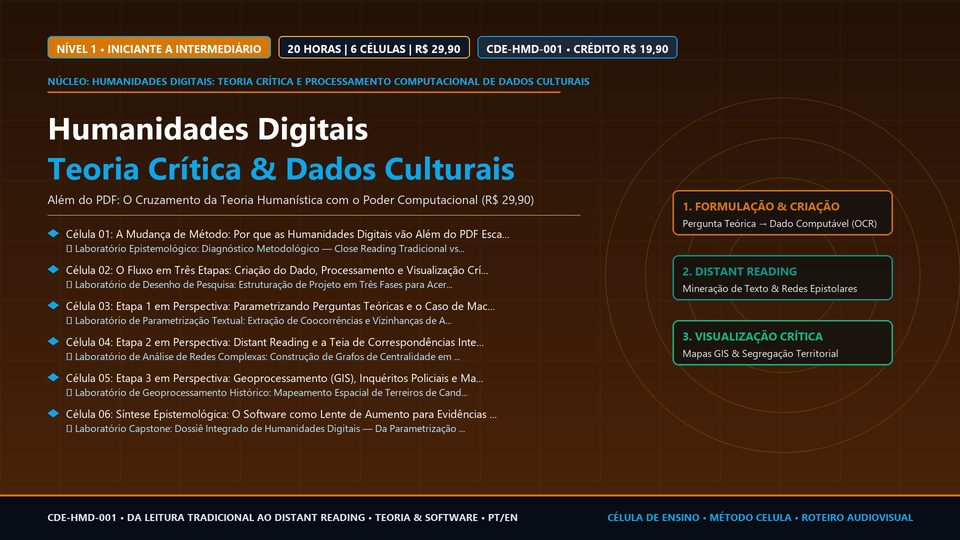
Humanidades Digitais: Teoria Crítica, Processamento de Grandes Volumes de Dados Culturais e Leitura Distante R$ 29,90
Humanidades Digitais: Teoria Crítica e Processamento Computacional de Dados Culturais

Humanidades Digitais: Teoria Crítica, Processamento de Grandes Volumes de Dados Culturais e Leitura Distante

Compreenda por que as Humanidades Digitais não são apenas escanear livros em PDF, mas uma mudança de método que cruza teoria crítica e computação em três etapas: formulação da pergunta e criação do dado, processamento macroscópico e visualização crítica.

📚 12 células ⏱️ 20h Iniciante a Intermediário
Jornada da trilha

Células de aprendizagem

1

01. Como um computador funciona

Compreender o papel de cada componente do PC sob a ótica de IA (CPU, RAM, NVMe, placa-mãe, fonte, GPU) e o fluxo de dados na inferência.

10 min
2

01. Como um computador funciona

Compreender o papel de cada componente do PC sob a ótica de IA (CPU, RAM, NVMe, placa-mãe, fonte, GPU) e o fluxo de dados na inferência.

15 min 🎙️ Áudio
3

01. Como um computador funciona

Compreender o papel de cada componente do PC sob a ótica de IA (CPU, RAM, NVMe, placa-mãe, fonte, GPU) e o fluxo de dados na inferência.

15 min 🎙️ Áudio
4

02. Ferramentas e segurança

Organizar a bancada de trabalho, prevenir descargas eletrostáticas (ESD), manusear ferramentas magnéticas adequadas e prezar pela segurança elétrica.

10 min
5

02. Ferramentas e segurança

Organizar a bancada de trabalho, prevenir descargas eletrostáticas (ESD), manusear ferramentas magnéticas adequadas e prezar pela segurança elétrica.

15 min 🎙️ Áudio
6

02. Ferramentas e segurança

Organizar a bancada de trabalho, prevenir descargas eletrostáticas (ESD), manusear ferramentas magnéticas adequadas e prezar pela segurança elétrica.

15 min 🎙️ Áudio
7

03. Montagem guiada

Executar a montagem física completa do computador do zero: processador, cooler, memória, SSD, placa-mãe, fonte e GPU, com primeiro boot e validação de BIOS.

10 min
8

03. Montagem guiada

Executar a montagem física completa do computador do zero: processador, cooler, memória, SSD, placa-mãe, fonte e GPU, com primeiro boot e validação de BIOS.

15 min 🎙️ Áudio
9

03. Montagem guiada

Executar a montagem física completa do computador do zero: processador, cooler, memória, SSD, placa-mãe, fonte e GPU, com primeiro boot e validação de BIOS.

15 min 🎙️ Áudio
10

04. Primeiro projeto de IA

Instalar o Ollama, baixar modelo local de 7 bilhões de parâmetros, medir tokens por segundo e analisar o comportamento da VRAM versus RAM.

10 min
11

04. Primeiro projeto de IA

Instalar o Ollama, baixar modelo local de 7 bilhões de parâmetros, medir tokens por segundo e analisar o comportamento da VRAM versus RAM.

15 min 🎙️ Áudio
12

04. Primeiro projeto de IA

Instalar o Ollama, baixar modelo local de 7 bilhões de parâmetros, medir tokens por segundo e analisar o comportamento da VRAM versus RAM.

15 min 🎙️ Áudio
13

05. A GPU é o centro

Dimensionar VRAM necessária por modelo e precisão (FP16 a INT4), entender CUDA, Tensor Cores e requisitos de memória para LLMs, difusão e treino de LoRA.

10 min
14

05. A GPU é o centro

Dimensionar VRAM necessária por modelo e precisão (FP16 a INT4), entender CUDA, Tensor Cores e requisitos de memória para LLMs, difusão e treino de LoRA.

15 min 🎙️ Áudio
15

05. A GPU é o centro

Dimensionar VRAM necessária por modelo e precisão (FP16 a INT4), entender CUDA, Tensor Cores e requisitos de memória para LLMs, difusão e treino de LoRA.

15 min 🎙️ Áudio
16

06. Memória e armazenamento

Dimensionar memória RAM do sistema (canais, frequência, ECC), escolher SSDs NVMe para leitura/escrita massiva de pesos e avaliar o custo do offloading.

10 min
17

06. Memória e armazenamento

Dimensionar memória RAM do sistema (canais, frequência, ECC), escolher SSDs NVMe para leitura/escrita massiva de pesos e avaliar o custo do offloading.

15 min 🎙️ Áudio
18

06. Memória e armazenamento

Dimensionar memória RAM do sistema (canais, frequência, ECC), escolher SSDs NVMe para leitura/escrita massiva de pesos e avaliar o custo do offloading.

15 min 🎙️ Áudio
19

07. CPU, placa-mãe e plataforma

Mapear linhas PCIe, bifurcação, chipsets e soquetes, distinguindo plataformas de consumo de workstations HEDT (Threadripper, Xeon).

10 min
20

07. CPU, placa-mãe e plataforma

Mapear linhas PCIe, bifurcação, chipsets e soquetes, distinguindo plataformas de consumo de workstations HEDT (Threadripper, Xeon).

15 min 🎙️ Áudio
21

07. CPU, placa-mãe e plataforma

Mapear linhas PCIe, bifurcação, chipsets e soquetes, distinguindo plataformas de consumo de workstations HEDT (Threadripper, Xeon).

15 min 🎙️ Áudio
22

08. Fonte, refrigeração e gabinete

Dimensionar fontes com folga para picos transitórios, operar conector 12V-2x6, projetar fluxo de ar de pressão positiva e selecionar refrigeração para cargas de horas.

10 min
23

08. Fonte, refrigeração e gabinete

Dimensionar fontes com folga para picos transitórios, operar conector 12V-2x6, projetar fluxo de ar de pressão positiva e selecionar refrigeração para cargas de horas.

15 min 🎙️ Áudio
24

08. Fonte, refrigeração e gabinete

Dimensionar fontes com folga para picos transitórios, operar conector 12V-2x6, projetar fluxo de ar de pressão positiva e selecionar refrigeração para cargas de horas.

15 min 🎙️ Áudio
25

09. Projeto de especificação

Especificar 3 configurações completas (entrada, intermediária e avançada) com orçamento, justificativas técnicas e plano de upgrade futuro.

10 min
26

09. Projeto de especificação

Especificar 3 configurações completas (entrada, intermediária e avançada) com orçamento, justificativas técnicas e plano de upgrade futuro.

15 min 🎙️ Áudio
27

09. Projeto de especificação

Especificar 3 configurações completas (entrada, intermediária e avançada) com orçamento, justificativas técnicas e plano de upgrade futuro.

15 min 🎙️ Áudio
28

10. A stack de IA

Instalar drivers NVIDIA, CUDA Toolkit, cuDNN, configurar Ubuntu nativo ou WSL2, gerenciar ambientes virtuais Python e Docker com suporte a GPU.

10 min
29

10. A stack de IA

Instalar drivers NVIDIA, CUDA Toolkit, cuDNN, configurar Ubuntu nativo ou WSL2, gerenciar ambientes virtuais Python e Docker com suporte a GPU.

15 min 🎙️ Áudio
30

10. A stack de IA

Instalar drivers NVIDIA, CUDA Toolkit, cuDNN, configurar Ubuntu nativo ou WSL2, gerenciar ambientes virtuais Python e Docker com suporte a GPU.

15 min 🎙️ Áudio
31

11. Rodar e treinar modelos

Operar os três principais fluxos de IA local: inferência de LLMs com vLLM e llama.cpp, geração de imagens com ComfyUI e treinamento de adaptadores LoRA.

10 min
32

11. Rodar e treinar modelos

Operar os três principais fluxos de IA local: inferência de LLMs com vLLM e llama.cpp, geração de imagens com ComfyUI e treinamento de adaptadores LoRA.

15 min 🎙️ Áudio
33

11. Rodar e treinar modelos

Operar os três principais fluxos de IA local: inferência de LLMs com vLLM e llama.cpp, geração de imagens com ComfyUI e treinamento de adaptadores LoRA.

15 min 🎙️ Áudio
34

12. Benchmark e otimização

Medir métricas de desempenho (tokens/s, latência, tempo por imagem), aplicar undervolting, ajustar curvas de ventoinha e combater o thermal throttling.

10 min
35

12. Benchmark e otimização

Medir métricas de desempenho (tokens/s, latência, tempo por imagem), aplicar undervolting, ajustar curvas de ventoinha e combater o thermal throttling.

15 min 🎙️ Áudio
36

12. Benchmark e otimização

Medir métricas de desempenho (tokens/s, latência, tempo por imagem), aplicar undervolting, ajustar curvas de ventoinha e combater o thermal throttling.

15 min 🎙️ Áudio
37

13. Projeto de estação de IA

Consolidar hardware, montagem, instalação da stack de software e otimização térmica em uma estação completa e documentada de Nível 3.

10 min
38

13. Projeto de estação de IA

Consolidar hardware, montagem, instalação da stack de software e otimização térmica em uma estação completa e documentada de Nível 3.

15 min 🎙️ Áudio
39

13. Projeto de estação de IA

Consolidar hardware, montagem, instalação da stack de software e otimização térmica em uma estação completa e documentada de Nível 3.

15 min 🎙️ Áudio
40

14. Multi-GPU

Decidir arquiteturas com múltiplas placas de vídeo, compreender NVLink vs barramento PCIe e aplicar paralelismo de tensor, pipeline e dados.

10 min
41

14. Multi-GPU

Decidir arquiteturas com múltiplas placas de vídeo, compreender NVLink vs barramento PCIe e aplicar paralelismo de tensor, pipeline e dados.

15 min 🎙️ Áudio
42

14. Multi-GPU

Decidir arquiteturas com múltiplas placas de vídeo, compreender NVLink vs barramento PCIe e aplicar paralelismo de tensor, pipeline e dados.

15 min 🎙️ Áudio
43

15. Workstation e servidor

Projetar estações de alta densidade em gabinetes de rack 4U e open frame, dimensionar circuitos elétricos dedicados e planejar fontes redundantes.

10 min
44

15. Workstation e servidor

Projetar estações de alta densidade em gabinetes de rack 4U e open frame, dimensionar circuitos elétricos dedicados e planejar fontes redundantes.

15 min 🎙️ Áudio
45

15. Workstation e servidor

Projetar estações de alta densidade em gabinetes de rack 4U e open frame, dimensionar circuitos elétricos dedicados e planejar fontes redundantes.

15 min 🎙️ Áudio
46

16. Rede e armazenamento

Integrar redes locais de 2.5G e 10Gbps, configurar armazenamento em rede NAS com RAID para datasets e implantar acesso remoto seguro via SSH e VPN.

10 min
47

16. Rede e armazenamento

Integrar redes locais de 2.5G e 10Gbps, configurar armazenamento em rede NAS com RAID para datasets e implantar acesso remoto seguro via SSH e VPN.

15 min 🎙️ Áudio
48

16. Rede e armazenamento

Integrar redes locais de 2.5G e 10Gbps, configurar armazenamento em rede NAS com RAID para datasets e implantar acesso remoto seguro via SSH e VPN.

15 min 🎙️ Áudio
49

17. Custo, nuvem e decisão

Calcular o Custo Total de Propriedade (TCO), depreciar hardware, computar custo elétrico por hora e modelar o ponto de equilíbrio entre infraestrutura local e nuvem.

10 min
50

17. Custo, nuvem e decisão

Calcular o Custo Total de Propriedade (TCO), depreciar hardware, computar custo elétrico por hora e modelar o ponto de equilíbrio entre infraestrutura local e nuvem.

15 min 🎙️ Áudio
51

17. Custo, nuvem e decisão

Calcular o Custo Total de Propriedade (TCO), depreciar hardware, computar custo elétrico por hora e modelar o ponto de equilíbrio entre infraestrutura local e nuvem.

15 min 🎙️ Áudio
52

18. Manutenção e diagnóstico

Diagnosticar travamentos, erros de memória de VRAM, quedas de energia, executar troca de pasta térmica e estruturar rotinas de manutenção preditiva.

10 min
53

18. Manutenção e diagnóstico

Diagnosticar travamentos, erros de memória de VRAM, quedas de energia, executar troca de pasta térmica e estruturar rotinas de manutenção preditiva.

15 min 🎙️ Áudio
54

18. Manutenção e diagnóstico

Diagnosticar travamentos, erros de memória de VRAM, quedas de energia, executar troca de pasta térmica e estruturar rotinas de manutenção preditiva.

15 min 🎙️ Áudio
55

19. Projeto final: Estação Multi-GPU para Caso Real

Desenvolver o projeto completo de uma estação profissional de IA para um cliente ou caso real: especificação, montagem, benchmarks, dossiê técnico e apresentação.

10 min
56

19. Projeto final: Estação Multi-GPU para Caso Real

Desenvolver o projeto completo de uma estação profissional de IA para um cliente ou caso real: especificação, montagem, benchmarks, dossiê técnico e apresentação.

15 min 🎙️ Áudio
57

19. Projeto final: Estação Multi-GPU para Caso Real

Desenvolver o projeto completo de uma estação profissional de IA para um cliente ou caso real: especificação, montagem, benchmarks, dossiê técnico e apresentação.

15 min 🎙️ Áudio